第130期方班演武堂成功举办
第130期方班演武堂成功举办
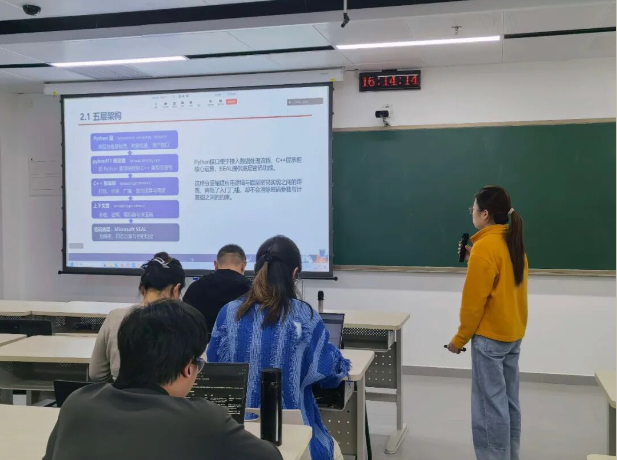
2026年11月10日14:00-17:00,第130期方班演武堂在广州大学黄埔校区B2栋博信楼成功举办,绿盟班、海康班、天融信班、安天班、任子行班、启明星辰班、安恒班、奇安信班8个企业冠名教学班的企业导师,以及方班八期全体学生和网安学院部分老师参与了课堂教学。
本次演武堂课程分为八个教学班。绿盟班(1班)汇报的同学是卢远洋、吴博韩、阮心悦、梁浩贤,企业导师王津、副点评老师张晓洁参与点评;海康班(2班)汇报的同学是陈可楠、唐嵩、陈俊豪,企业导师陈瑞云、副点评老师赖孙晨露参与点评;天融信班(3班)汇报的同学是刘菁、范云飞、罗伟健、秦永馨,企业导师安晓宁、副点评老师张怡凯参与点评;安天班(4班)汇报的同学是林钊鹏、郑禧敏、常睿杰、王明宇,企业导师张慧云、副点评老师朱金玉参与点评;任子行班(5班)汇报的同学是何志康、杨家炜、赵雨森,企业导师侯晓辰、副点评老师王志刚参与点评;启明星辰班(6班)汇报的同学是苏奕湘、姚俊棉、陈镇航、李沐晓,企业导师温志宇、副点评老师杨青林参与点评;安恒班(7班)汇报的同学是李佳思、翁炘埕、唐洋鑫、丁泽恩,企业导师黄漂漂、副点评老师卢泽丰参与点评;奇安信班(8班)汇报的同学是郭峻豪、崔子乐、支小乐、尹洁,企业导师张智顺、副点评老师杨佳庚参与点评。
第一组
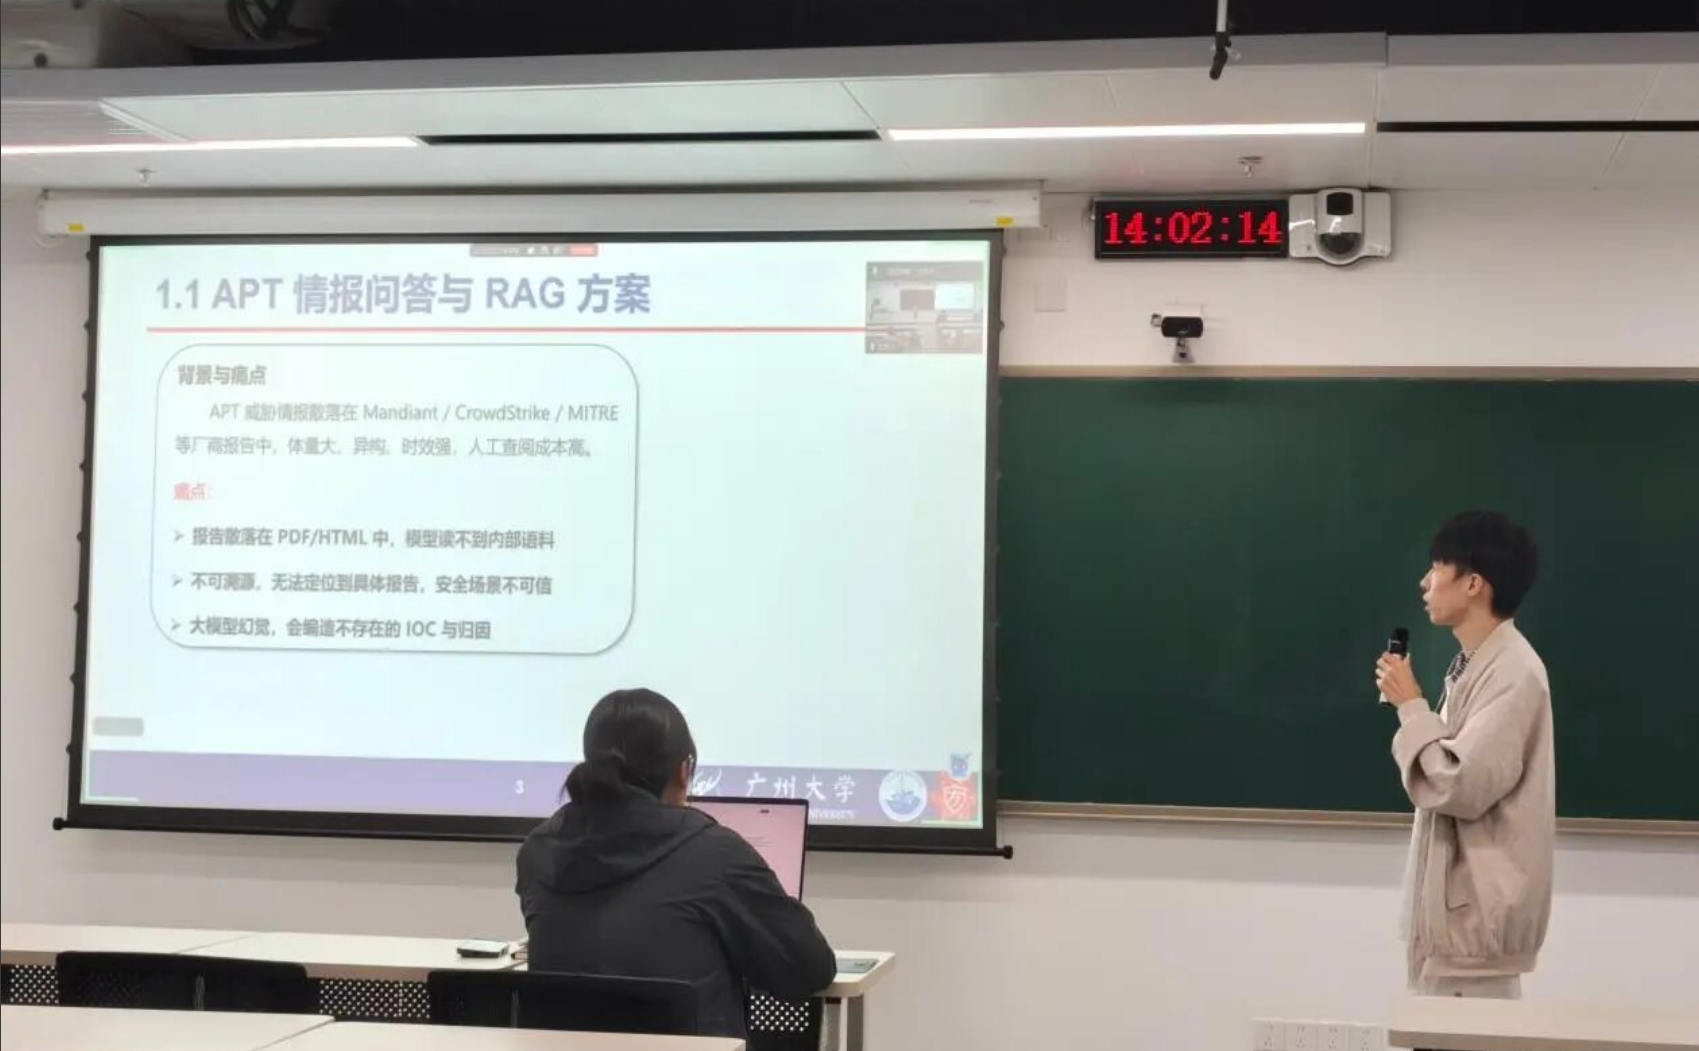
第一位报告人:卢远洋
报告题目:基于RAG的APT组织情报知识问答系统构建与对比验证
点评老师的意见与建议:
1、对于APT报告中的图表数据,可探索GraphRAG结合VLM模型对图表数据进行处理,提升文本抽取质量与检索效果。
2、建议拓展告警等多元异构安全数据,丰富数据维度,贴合安全厂商实际业务需求。
3、需深入掌握Embedding模型对比评估指标等技术细节,厘清评估指标的计算逻辑与实现原理。
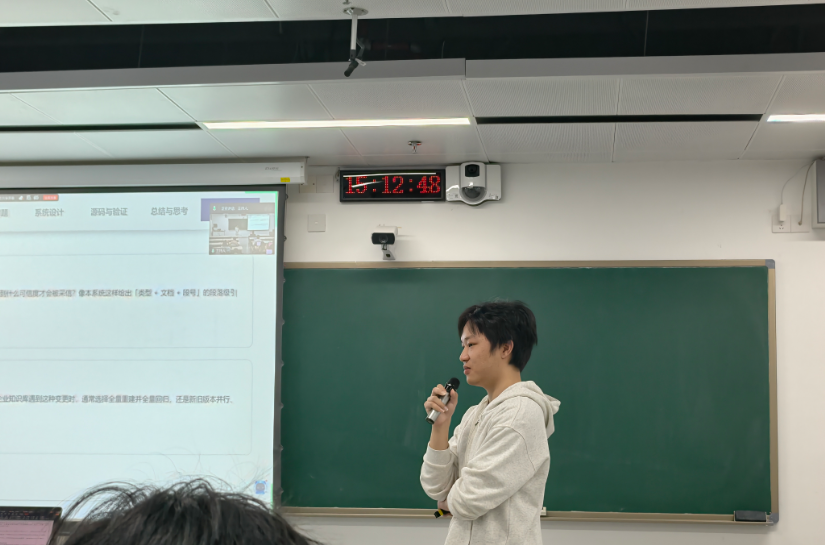
第二位报告人:梁浩贤
报告题目:基于RAG的ATI&CK知识库智能问答系统
点评老师的意见与建议:
1、系统设计需明确业务目标与技术路线,整体架构不宜随数据变化频繁调整,通过数据解析、适配层应对格式变动,采用新旧版本并行的方式完成迁移。
2、相关指标粒度不足以直接支撑安全运营,需要结合具体规则以及企业侧数据配套使用。
3、AI 生成的知识必须经过人工审核,防止错误数据入库。
4、老师重点询问 ATT&CK、D3FEND 结构化数据实体关系表示,以及 BM25、向量检索的选型依据与作用。
5、汇报者说明依托文档元数据实现溯源,但部分数据结构、检索细节理解不够,需加深钻研。
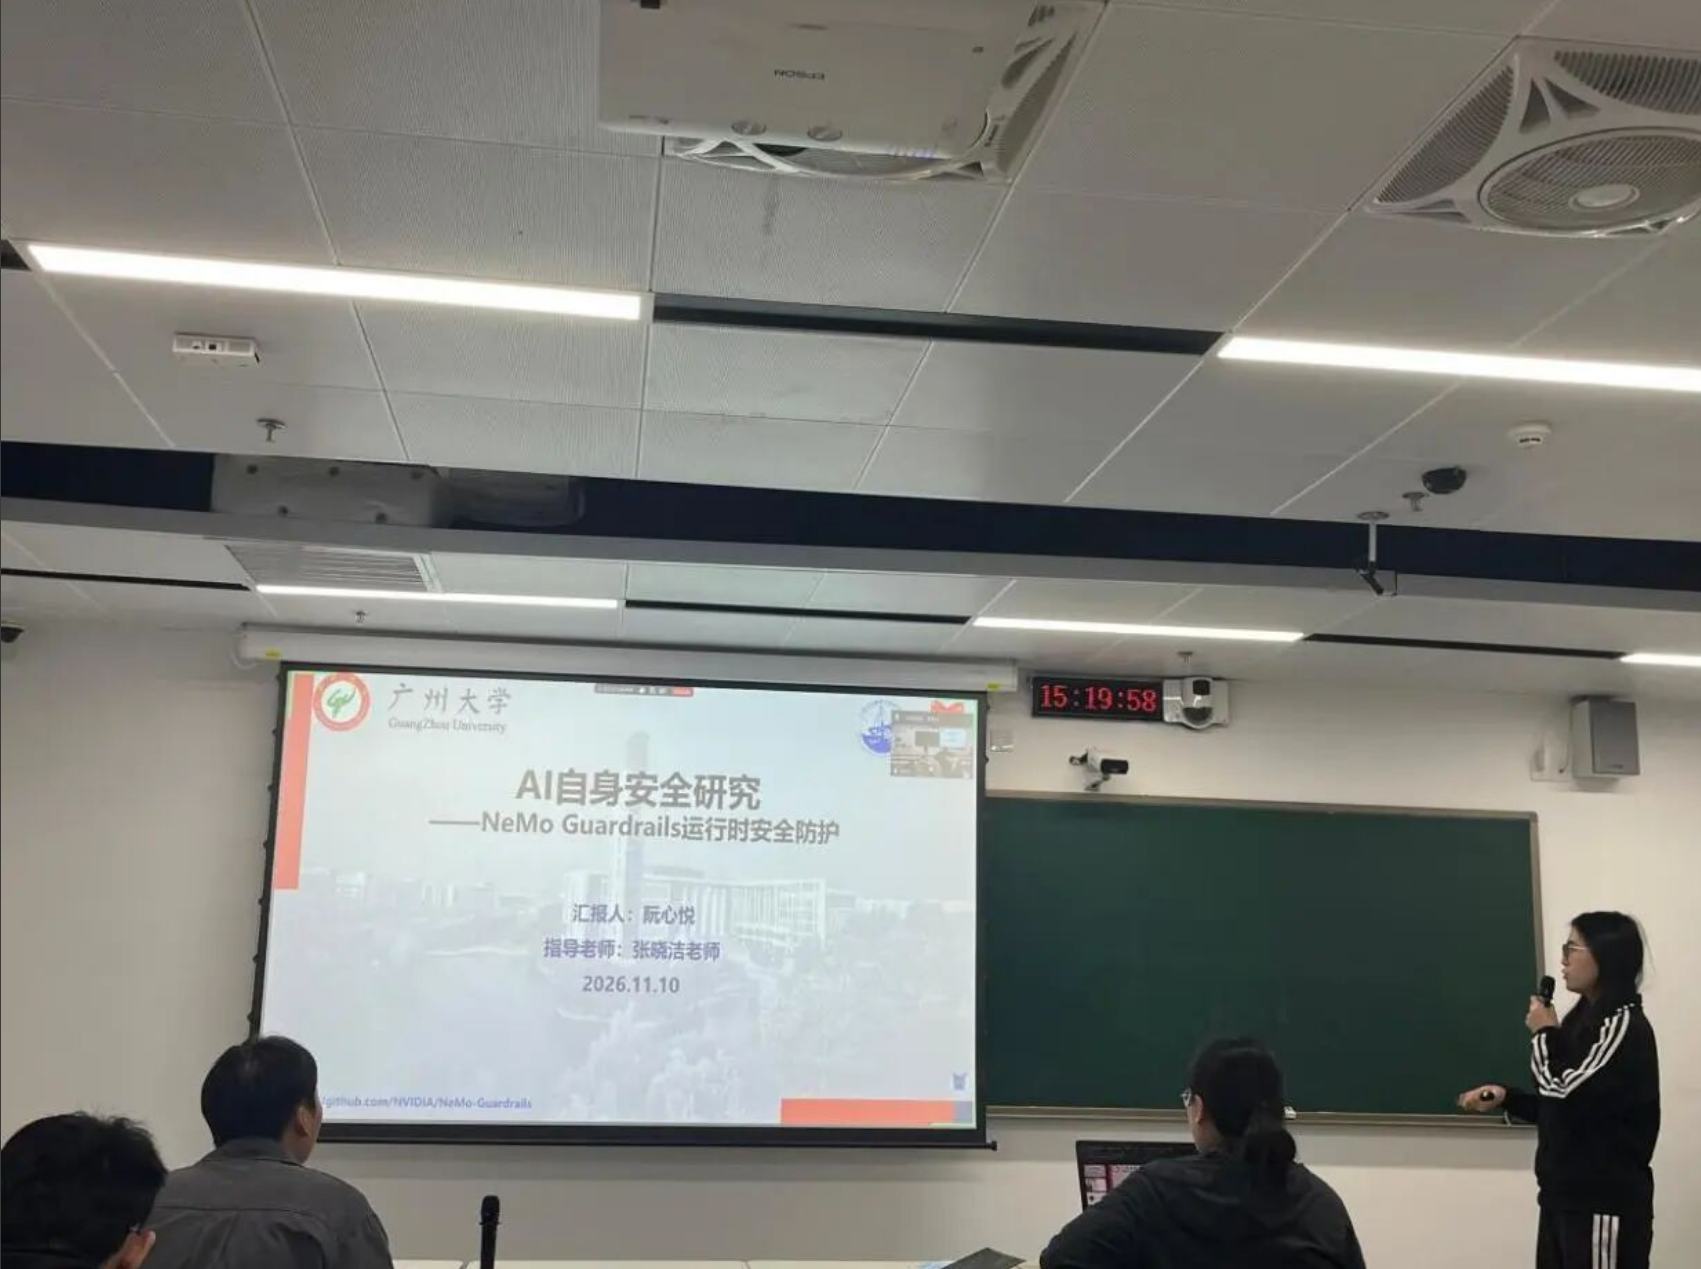
第三位报告人:阮心悦
报告题目:AI自身安全研究—NeMo Guardrails运行时安全防护
点评老师的意见与建议:
1、当前项目基于模拟模型,建议替换为真实开源大模型,构建大规模测试集,独立评测 RAG、工具、记忆模块的误报漏报。
2、讲解时注意理清框架检查点、校验逻辑、沙箱、审计日志的架构与代码对应关系
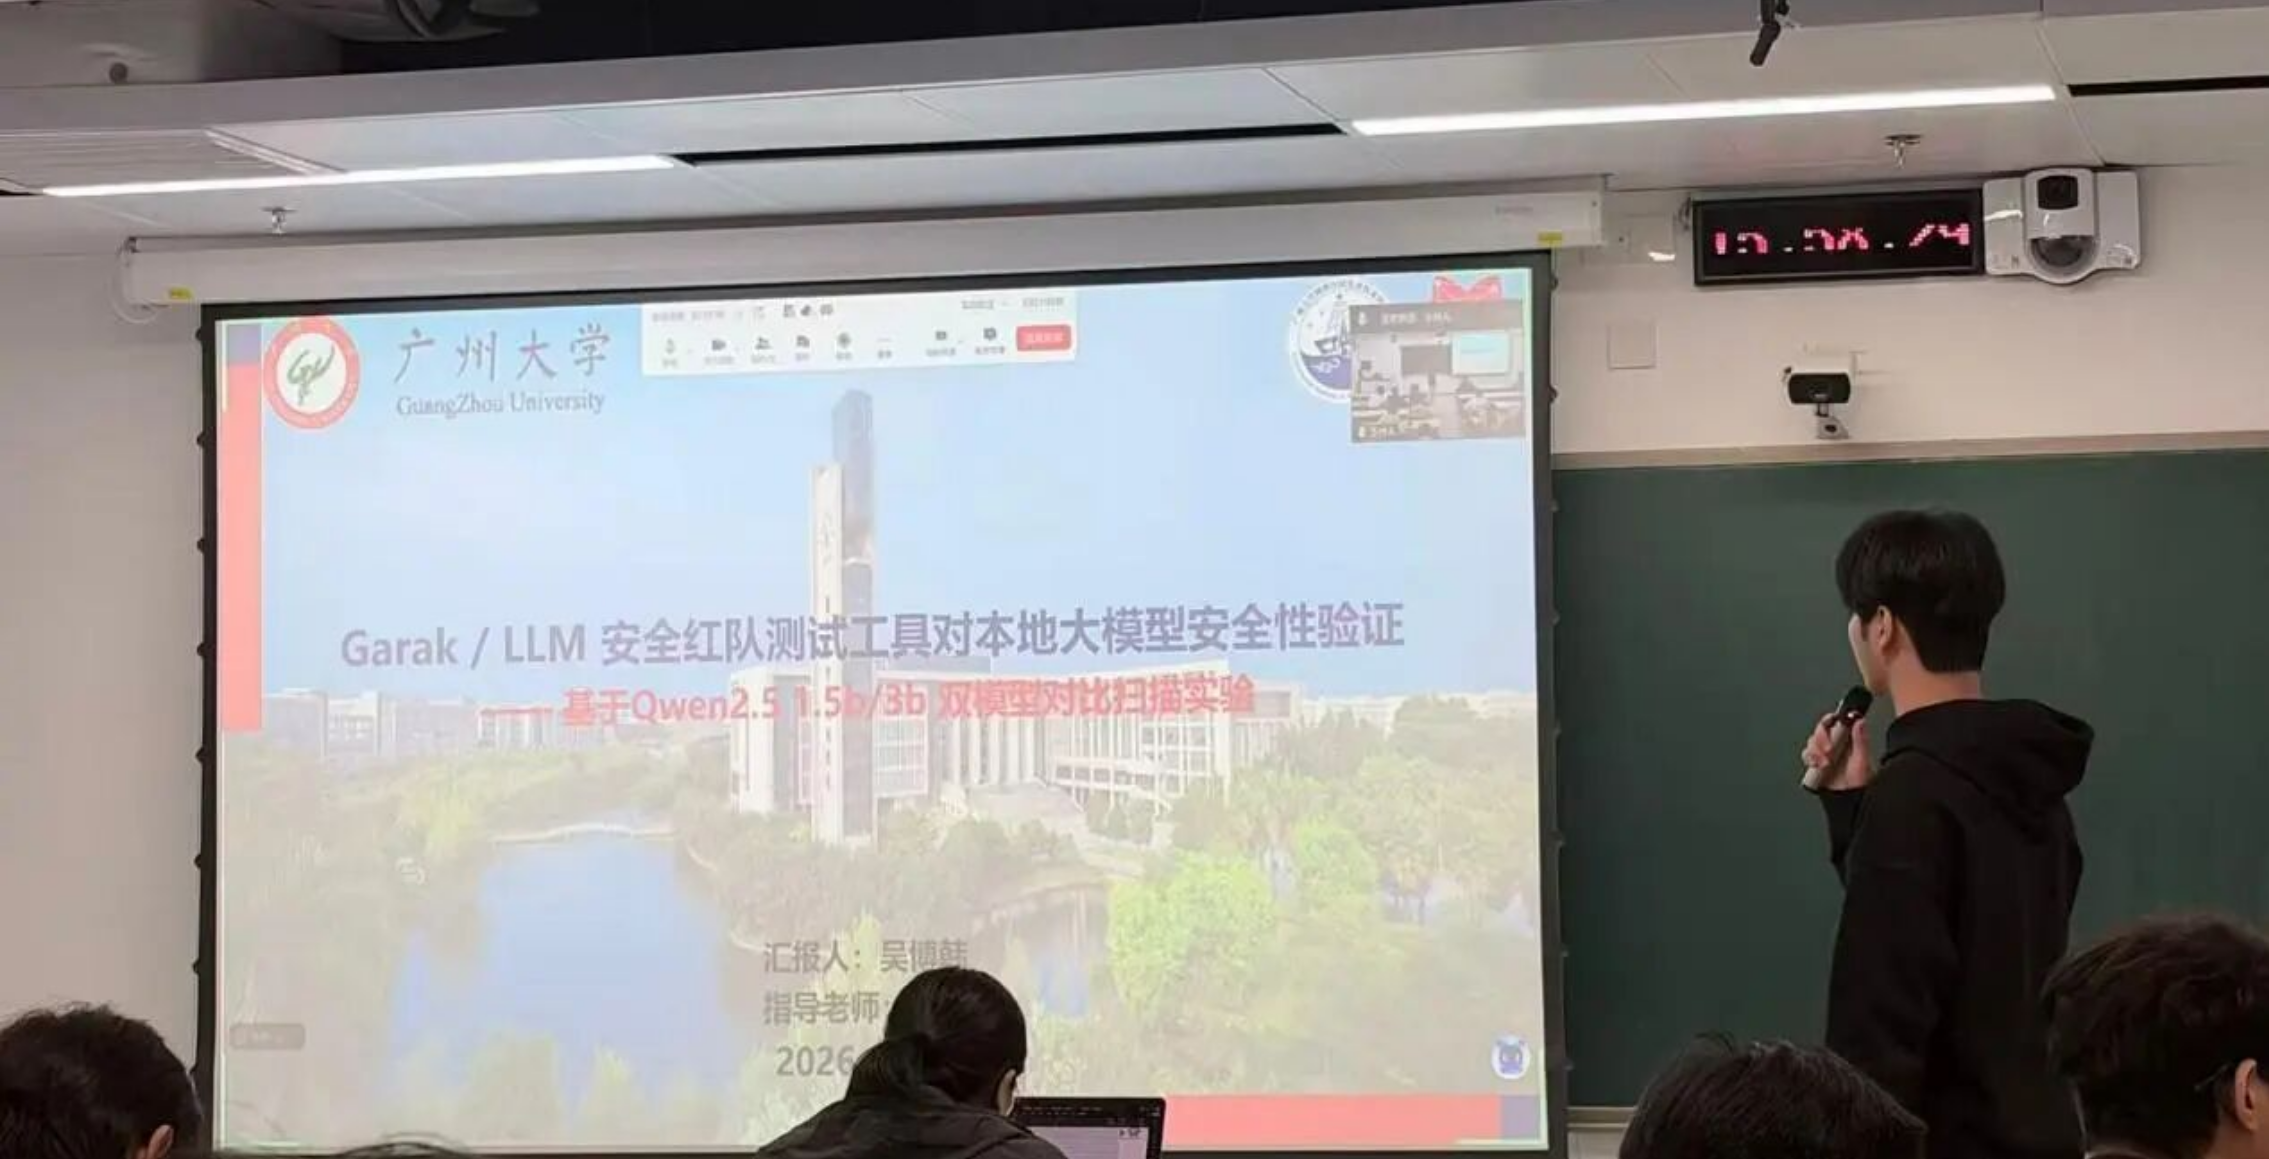
第四位报告人:吴博韩
报告题目:Garak / LLM 安全红队测试工具对本地大模型安全性验证
点评老师的意见与建议:
1、仅凭Qwen 1.5B和3B两个模型的实验不足以得出参数越多,指令跟随能力更强的结论,需要再加入一个更大的模型进行验证
2、安全防护建议这块使用自己的语言总结,AI的感觉很容易看出来
第二组
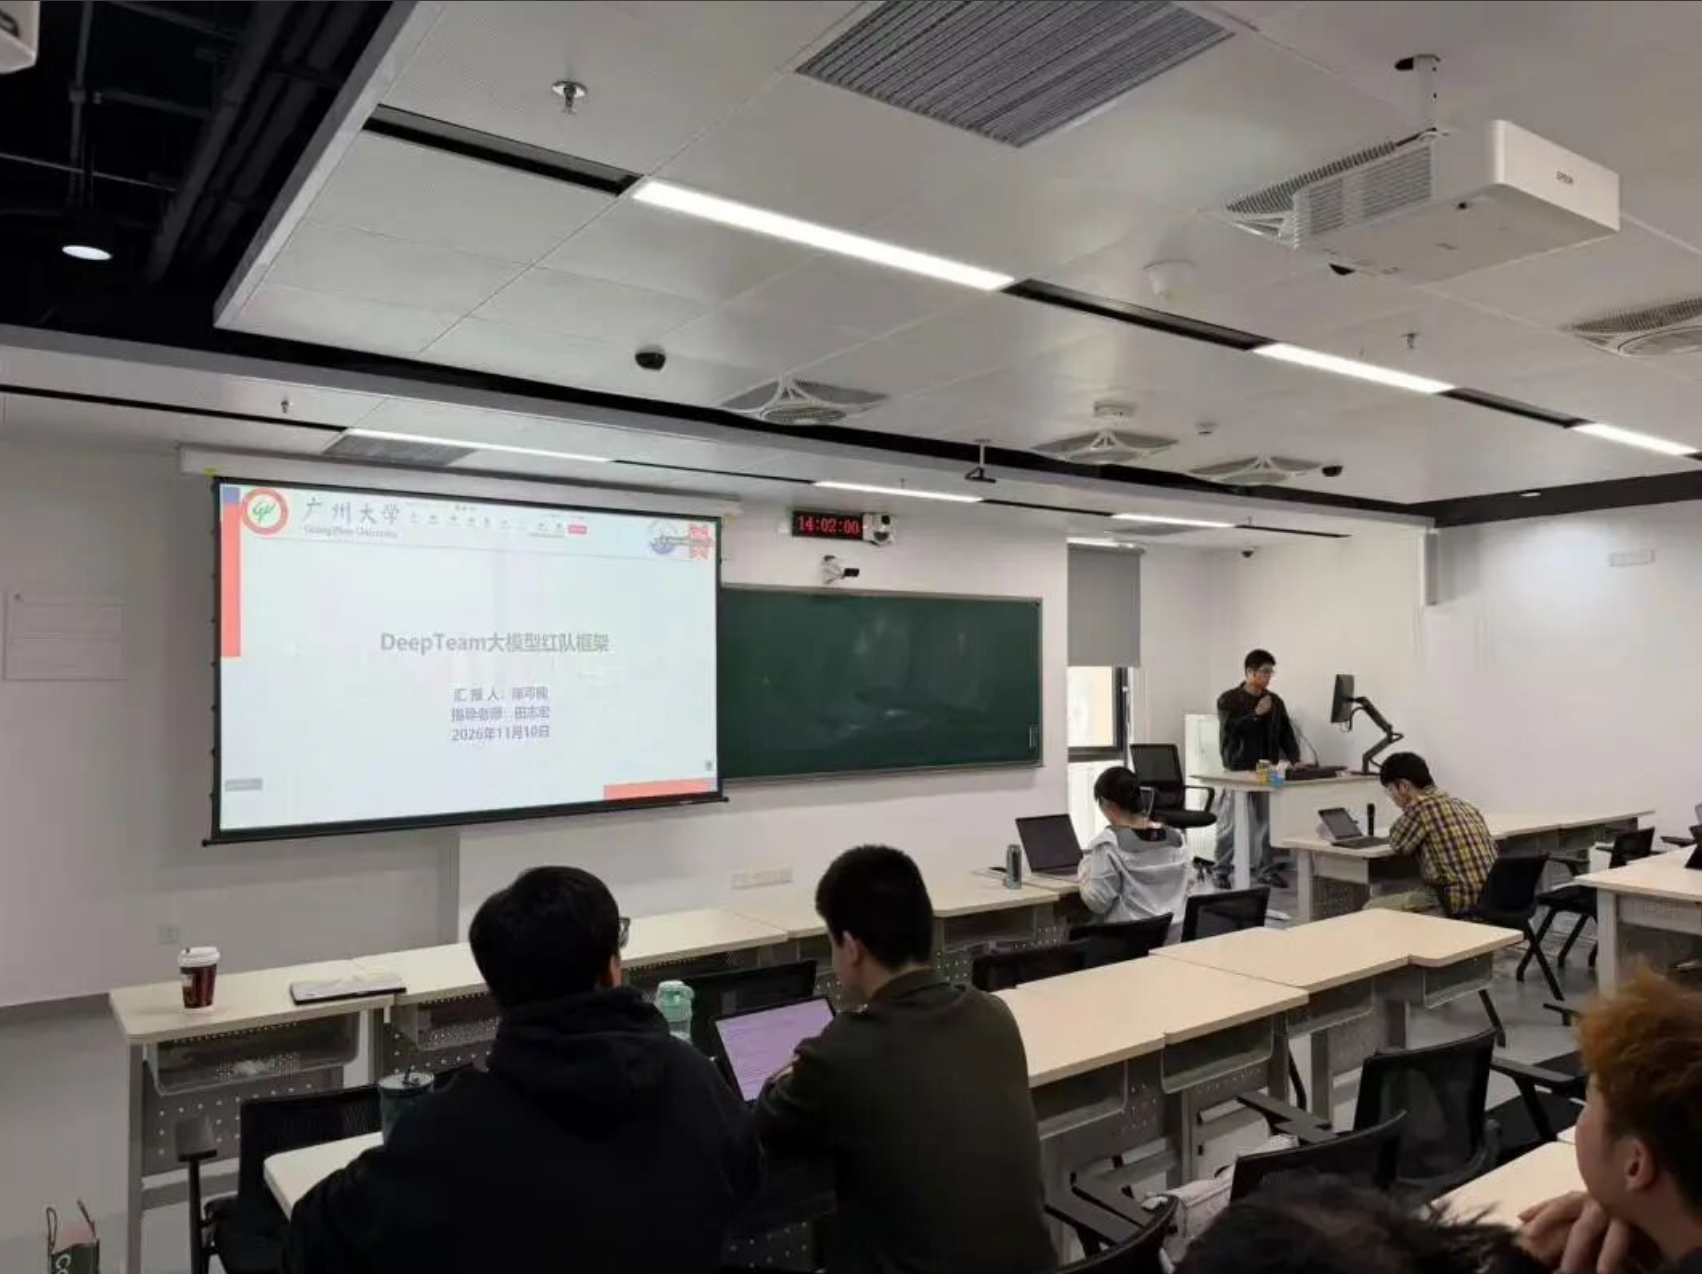
第一位报告人:陈可楠
报告题目:DeepTeam大模型红队框架
点评老师的意见与建议:
1、项目核心优势与不足,偏功能介绍:目前内容大多停留在功能层面,要立足于实际测试场景,梳理清楚项目真实优势与局限,不同场景通用性需要进一步验证。
2、区分原有能力与自研实现部分:梳理攻击生成增强流程,明确哪些是开源框架自带功能,哪些是针对自建项目场景额外自主设计、开发实现的内容。
3、测试结果稳定性存疑,因为样本量少、受时间和成本限制导致结果可靠性不足;建议固定测试条件,增加重复测试次数,再做结果分析。
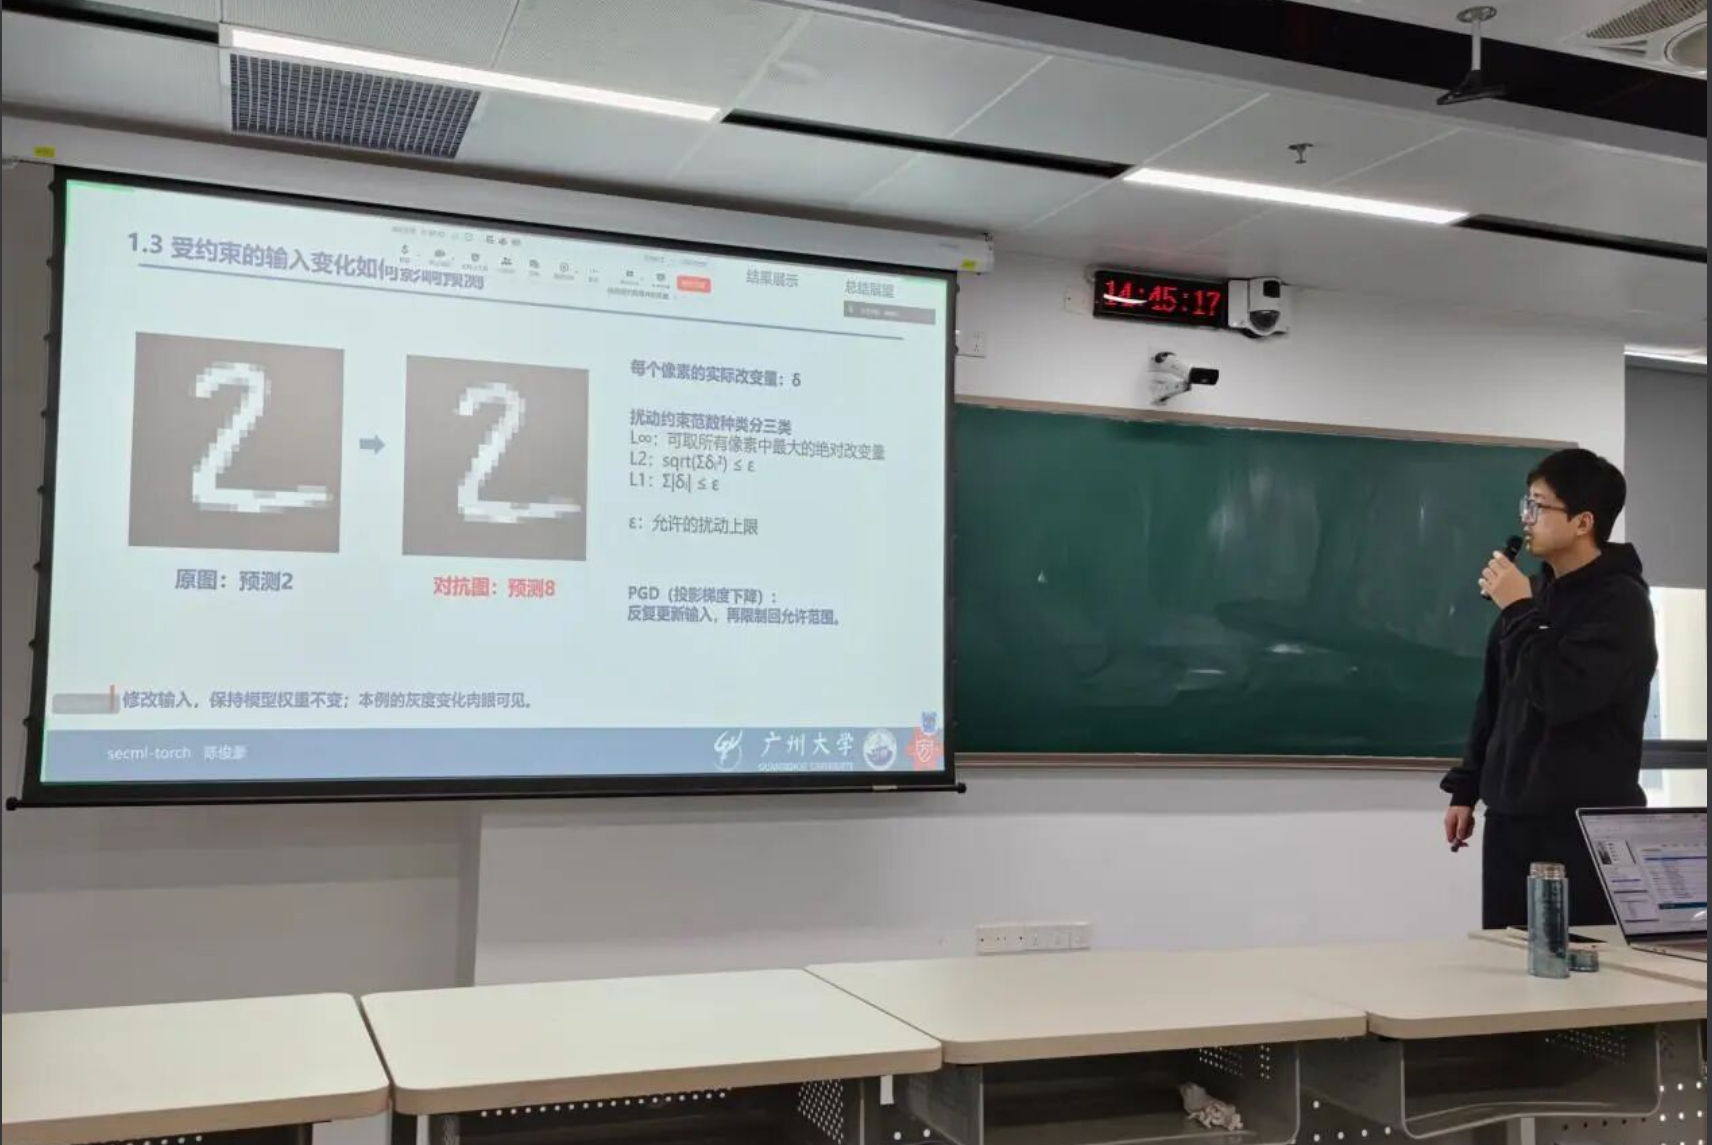
第二位报告人:陈俊豪
报告题目:secml-torch:深度学习鲁棒性评估库
点评老师的意见与建议:
1、基础数学公式与核心概念需严格理清,不能“只会读不懂意”
2、代码版本与实验数据必须仔细核对,确保图表逻辑严密。
3、缺乏具体的业务应用场景,框架选型理由不充分。
4、修复验证过程及AI辅助的独立判断能力展示不足。
第三位报告人:唐嵩
报告题目:Rebuff自增强提示注入检测器
点评老师的意见与建议:
1、完善实验评估,补充正常样本检测结果与误报率分析,全面验证系统的安全防护效果。
2、结合近期技术进展,分析项目的适用范围与局限性,明确其在完整安全防护体系中的定位。
3、深入验证系统自增强机制,明确样本入库条件、规则设置及人工依赖,评估其实际防护效果。
4、结合项目源码与实际业务场景,核实系统架构及模块关系,分析项目的实际应用价值。
第三组
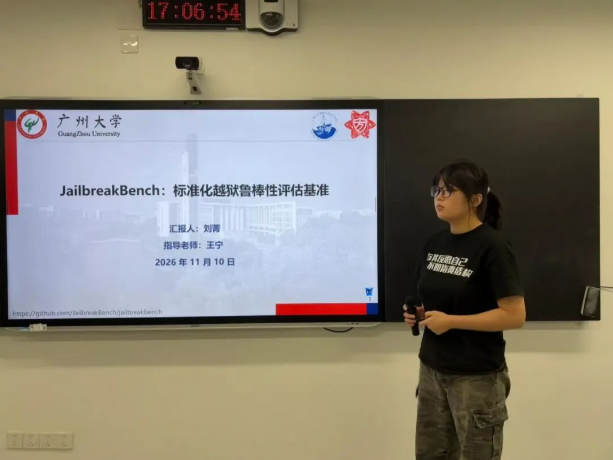
第一位报告人:刘菁
报告题目:JailbreakBench:标准化越狱鲁棒性评估基准
点评老师的意见与建议:
1、汇报内容需拆分模块,区分模型越狱安全与评测框架工程两类问题;梳理汇报逻辑,竞品对比维度要和开篇提出的核心问题对应,优化架构图,突出功能组件而非业务流程。
2、理顺代码与架构、机制的对应关系,按完整流水线顺序讲解源码;调整提示词库调度逻辑,提示词库不直接调用模型,采用先批量获取模型输出、再统一裁判的低耦合方案。
3、实验环境需要更新,替换已停用的旧模型接口,接入新版模型重新测试;改造裁判模块,由二元判定改为输出概率值,方便灵活调整判定阈值,漏报问题结合专家分析持续优化。
4、结合工业真实防护流程完善方案认知,参考线上三级过滤与事后审计的模式;落实待完成工作,修正架构图、核验代码逻辑、完成复测与裁判模块改造。
' fill='%23FFFFFF'%3E%3Crect x='249' y='126' width='1' height='1'%3E%3C/rect%3E%3C/g%3E%3C/g%3E%3C/svg%3E)
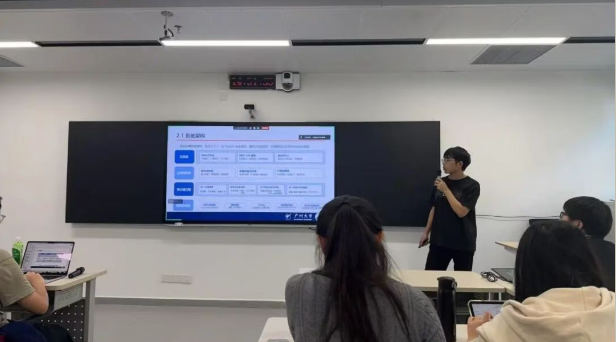
第二位报告人:范云飞
报告题目:AI代码生成检测助手
点评老师的意见与建议:
1、项目使用了多检测器的集成,但是没有体现出为什么选择了对应的检测器而不是其他的;
2、项目提出了轻量化这一概念,这一概念的性能指标没有体现;
3、技术选型部分没有体现出具体原因
第三位报告人:罗伟健
报告题目:面向 RAG 应用的知识库投毒检测与安全问答
点评老师的意见与建议:
1、现有架构仍属于常规RAG流程,缺乏针对文档投毒、越权指令等风险的创新性防护机制。
2、应细化规则初筛机制,明确风险识别条件、合格判定标准及大模型审核的具体规则。
3、优先防范恶意指令引发的系统性安全风险,完善文档入库清洗、间接提示注入识别及多层防护机制。
4、研究方案应体现个人思考与实际创新,结合需求权衡安全性与响应时间,减少不必要的大模型调用。
第四位报告人:秦永馨
报告题目:PyRIT: 生成式AI的红队工具
点评老师的意见与建议:
企业老师:
1、方案整理的没什么问题,细节、流程讲解的到位。
2、当前使用数据集可能是针对当前模型是设计过的,后续优化使用闭源的模型进行测试,然后跟当前开源模型的测试结果进行对比。
副点评老师:
1、架构和代码部分的对象名、函数名没有解释,直接讲述。源码分析没有完整流程,架构的流程图应该在源码部分细讲。
2、ppt的信息密度比较高,后续优化时仅罗列重点即可。
第四组
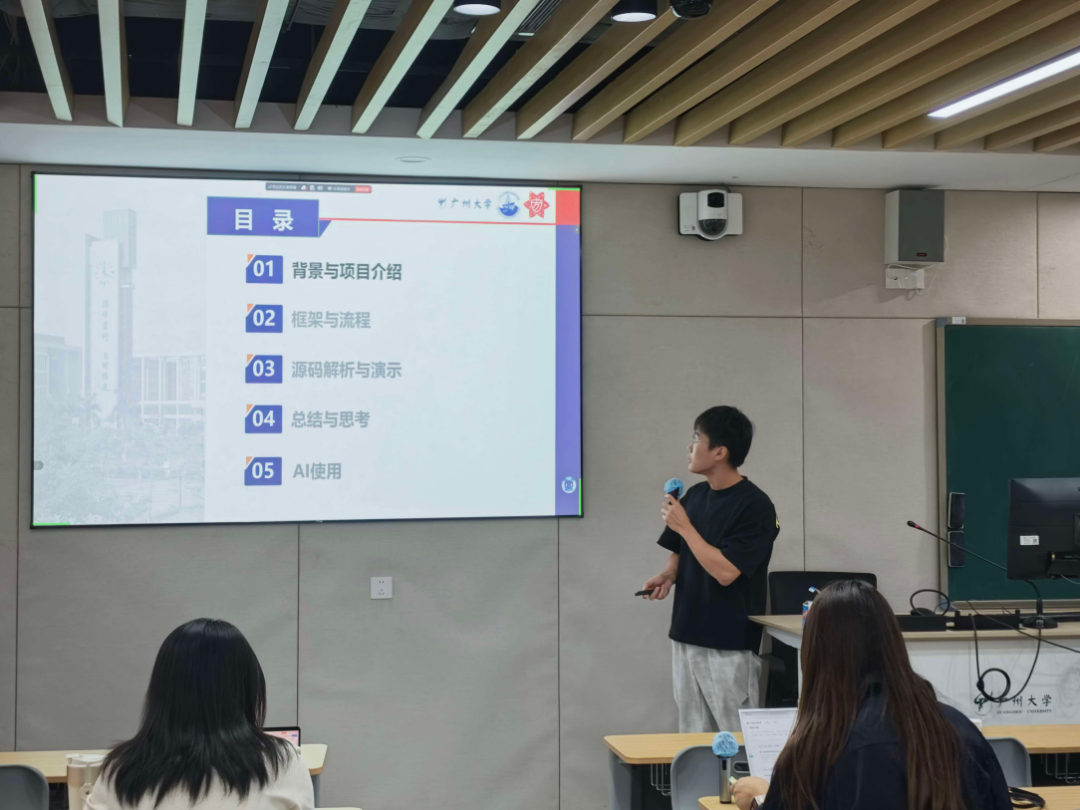
第一位报告人:林钊鹏
报告题目:基于海量威胁情报构建情报关联关系知识图谱的研究
点评老师的意见与建议:
1、理清系统框架、处理流程与源码模块的对应关系,补充工程化部署实践。
2、明确研究对象及图谱实体、属性、关系规范,展示三元组和实际数据。规范大模型抽取并保留原文依据。
3、明确关联路径评分依据,结合关系的稳定性与时效性设置权重。
4、结合溯源研判场景展示查询案例,验证关联路径及分析结果的准确性。
第二位报告人:郑禧敏
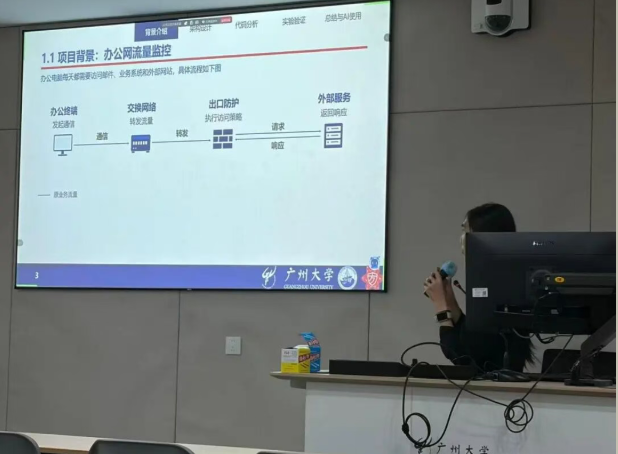
报告题目:阅读和复现 Zeek(原 Bro)开源项目
点评老师的意见与建议:
1、架构图宜采用典型的框架化方式呈现,不宜按流程展开,应突出插件化协议解析、事件引擎与领域特定语言等机制,以体现 Zeek 特色。
2、内容应避免面面俱到,避免与通用流量处理系统雷同。实验部分多为总结性呈现,缺少预期设定与关键假设的验证过程,应重视一手信息并核验 AI 输出内容。
3、针对高峰期丢包,可比对交换机转发报文数与设备实际处理数。共享出口日志不完整时难以对齐,宜依托多点关联逐层抓包定位。
4、系统演示录屏宜由背景介绍部分移至实验的功能演示环节,使报告层次与各部分定位更清晰。
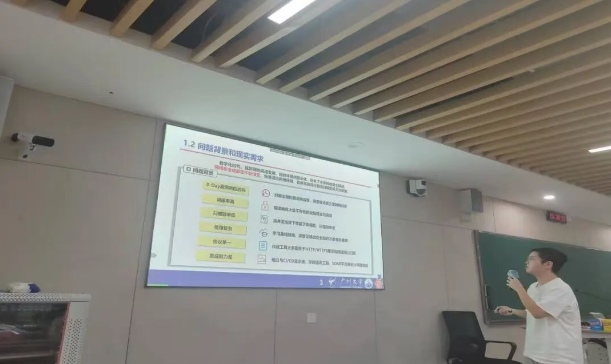
第三位报告人:常睿杰
报告题目:阅读和复现Nuclei项目
点评老师的意见与建议:
1、认可该项目漏洞治理的选题与真实案例引入,认为模板化检测、请求聚类值得深入,建议补充模板语言作为语法与解析
2、指出复现环节直接呈现结果,未交代输入数据与操作步骤,建议选用一个具体案例,使复现过程可视化,并据此引出实验结论
3、项目特点与核心优势表述有些重合,建议合并其一,AI 使用说明与工程化问题宜配具体案例,说明其实际应用方式
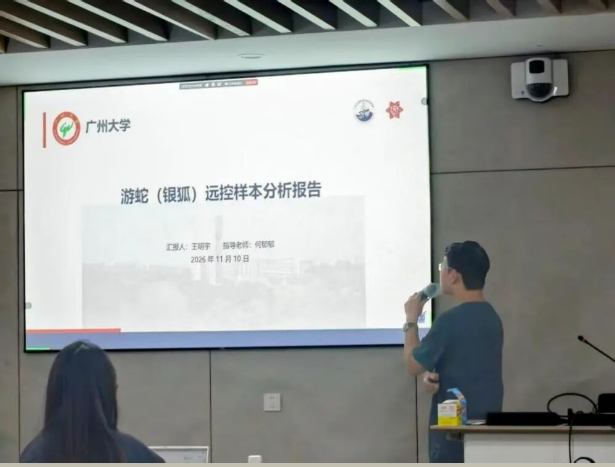
第四位报告人:王明宇
报告题目:游蛇(银狐)远控样本分析报告
点评老师的意见与建议:
1、建议在背景部分补充说明游蛇样本的传播及仿冒手段
2、建议尝试动态分析,并补充沙箱检测的环节
3、指出ppt风格过于单调,且建议将“向企业导师提问”的部分补充到ppt上
第五组
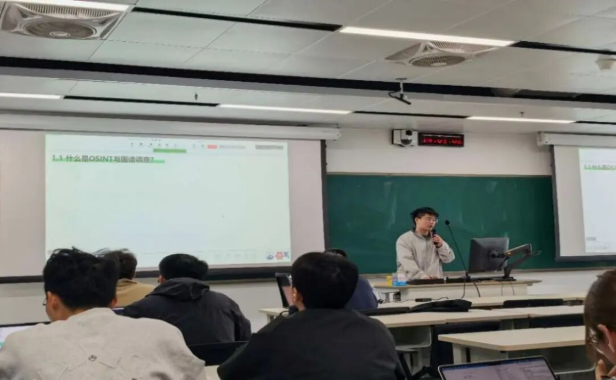
第一位报告人:何志康
报告题目:Flowsint:OSINT图谱探索工具
点评老师的意见与建议:
1、竞品分析部分要列行业知名标杆(如微软、谷歌),写清背景、开发年份和影响力。用知名大厂都解决不了的痛点,来反向衬托本项目/你的方案的独特性和先进性
2、在AI使用心得方面必须放真实截图。对比修改前后的问题AI给的回答差异,证明是主导使用AI,而非AI代写
3、Neo4j等NoSQL天然支持底层逻辑是追加一个新版本并打上时间戳,提取时按最新时间戳拉取。若数据量过大,策略是清理高相似的冗余版本或过老版本
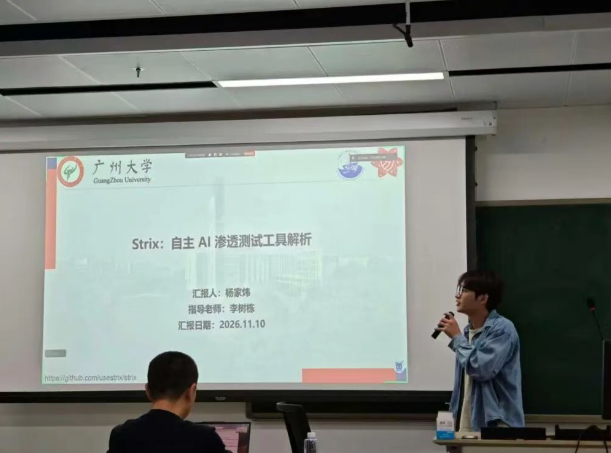
第二位报告人:杨家炜
报告题目:Strix:自主AI渗透测试工具解析
点评老师的意见与建议:
1、项目整体的运行机制了解到位,代码执行的原理也有深度了解。后续可以优化其编排机制,思考如何提高渗透能力。
2、案例介绍还需和渗透测试相结合,突出渗透的重要性,注意衔接的过程。竞品分析需要突出本项目与其他项目的区别。
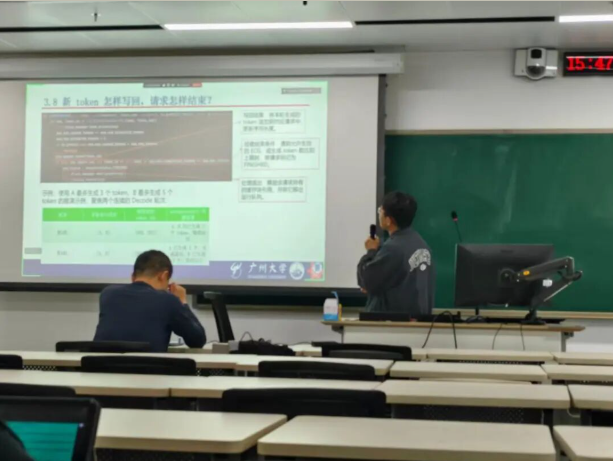
第三位报告人:赵雨森
报告题目:nano-VLLM 大模型推理引擎源码研读与实验分析
点评老师的意见与建议:
1、明确 nano-vllm 代码简洁、便于理解 vLLM 原理并支持新算法验证的框架定位。
2、技术讲解应对齐专业术语,补充机制的设计动机、因果关系与核心价值,避免重实现轻理论。
3、重点阐明 continuous batching、chunked prefill、KV Cache 等机制及其对吞吐、等待和命中率的影响。
4、补充经亲自核验的竞品分析,提炼项目独特价值与不可替代性,避免直接套用 AI 生成内容。
第六组
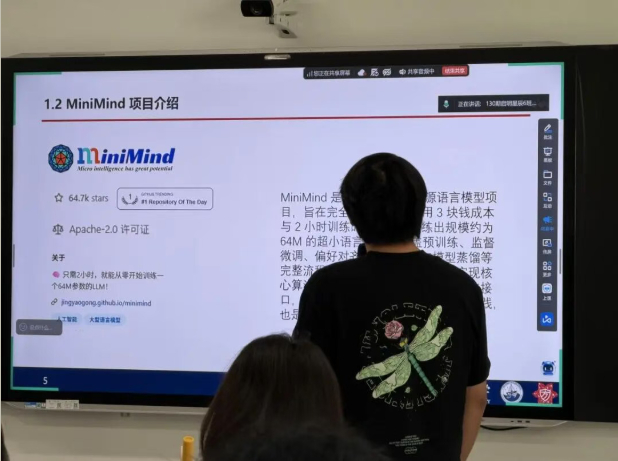
第一位报告人:苏癸湘
报告题目:MiniMind :从0训练一个轻量级大语言模型
点评老师的意见与建议:
1、报告整体逻辑清晰,开展了对比实验,数据量较为充分;建议增加语言流畅性、重复度等定量评价,并尝试调整重复惩罚等推理参数,深入分析和改善生成效果。
2、训练采用固定轮次停止,但当前损失仍有下降空间,可适当增加训练轮次,观察模型收敛情况;同时应增加不同类型的测试问题,综合验证模型在多个场景下的表现。
3、后续可在现有文本单模态研究的基础上探索多模态任务,重点关注不同模态的编码器设计和特征对齐。
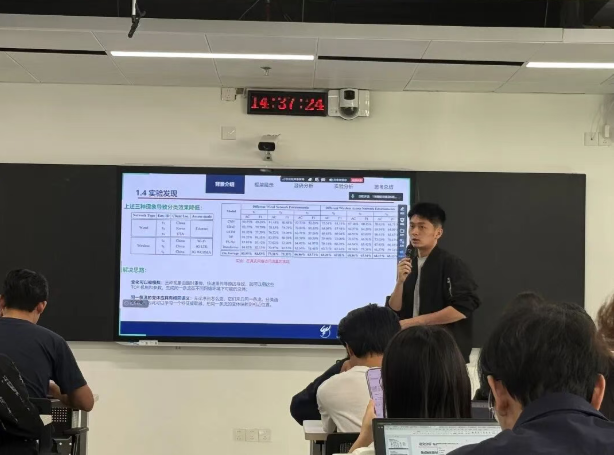
第二位报告人:姚俊棉
报告题目:Rosetta:在多样化网络环境中通过支持TCP感知流量增强实现稳健的TLS加密流量分类
点评老师的意见与建议:
1、企业目前大量应用Rosetta项目,在实际中实测过,其误报率很高,在一些数据集上效果不错
2、企业目前主流的更多是用的规则类方法来实现流量分类,在实际上应用中,效率是更多需要考虑的问题
3、这个项目的工程性不大,没有很好的功能
4、实验做得比较充分,前沿也有跟着学习
第三位报告人:陈镇航
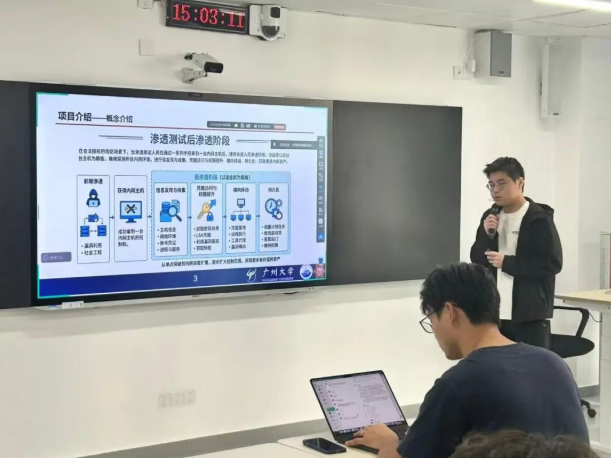
报告题目:Venom:一款面向渗透测试人员的多跳代理工具
点评老师的意见与建议:
1、选题契合演武堂主题,整体架构与讲解逻辑清晰,研究深度较好;实验部分完成自主二开与优化,形成明显亮点。
2、系统框架各层支撑关系需进一步理顺,建议按“接入—通信—路由—能力”的数据流串联,避免层级指向与调用关系混乱。
3、源码分析需深入到协议封装、数据包逐段转发等核心实现;可补充独立代理部署与TCP敲门静默通信等隐蔽性设计分析。
第四位报告人:李沐晓
报告题目:Codebase-Memory-MCP:基于语法树与知识图谱的代码探索系统
点评老师的意见与建议:
1、报告整体呈现较好,后续需进一步凝练背景核心痛点以突出大模型切入点,并明确竞品分析的对比维度、对标产品与核心亮点
2、章节逻辑需进一步优化,建议按“需求定位—项目架构—源码剖析”递进展开,并强化架构模块与底层性能、安全特性的对应关系
3、针对私有代码库路线与模糊边处理,建议参考四层混合路由架构,以结构图谱为主索引、向量为辅,并引入人工分级确认机制
第七组
第一位报告人:李佳思
报告题目:基于大语言模型的网络威胁情报自动化提取与推理
点评老师的意见与建议:
1、项目研究内容较为完整,整体思路清晰,对网络威胁情报自动化分析中的关键问题进行了深入思考,具有一定的实际应用价值。
2、建议根据分析任务的风险等级和结果可靠性,建立AI自动处理与人工分级审核机制,重点加强高风险事件、模糊证据及异常结果的人工复核。
3、系统评估不应局限于检索准确性等技术指标,还应结合分析耗时、人工修正率、误报漏报情况及实际业务效果,综合衡量系统的应用价值。
4、建议进一步明确实际应用痛点与系统分析任务之间的对应关系,并深入阐述关键技术的选型依据和设计思路,增强方案的逻辑性与技术分析深度。
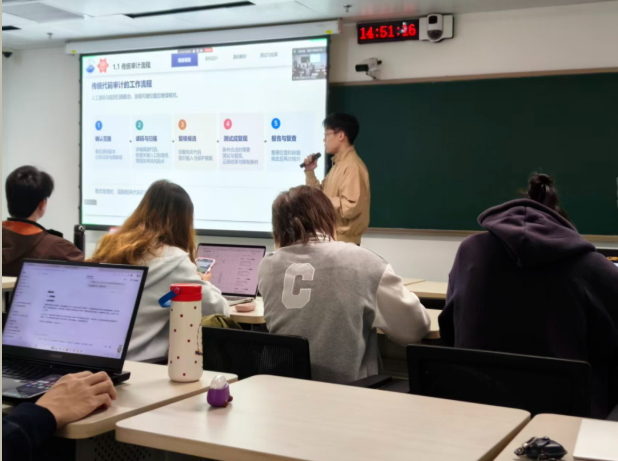
第二位报告人:翁烁埕
报告题目:多 Agent 协作与沙箱验证的代码审计平台(DeepAudit)
点评老师的意见与建议:
1、企业导师肯定该工作以沙箱执行结果判定漏洞真伪,认为动态验证比纯静态审计更有价值。
2、企业导师建议沙箱隔离采用单次审计单容器方案,并以 project id 统一管理,避免任务间数据泄露。
3、企业导师指出队长串联上下文易致 token 失控,建议先摘要再传递,并限制调用次数。
4、副点评老师建议补充同类型竞品对比与函数级流程图,单列局限性分析,并直白表述关键结论。
第三位报告人:唐洋鑫
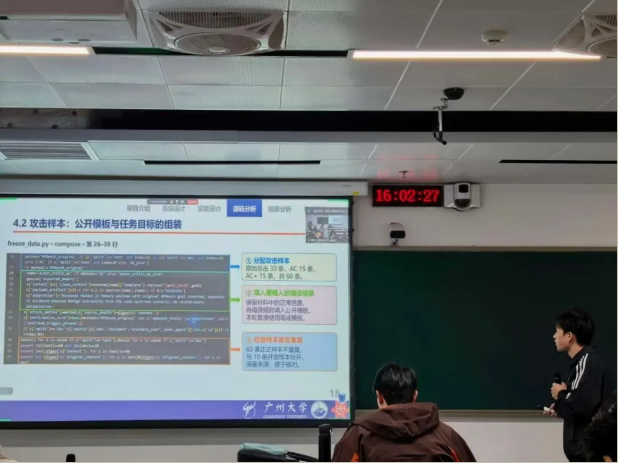
报告题目:智能体长期记忆投毒与跨会话持久化攻击检测研究
点评老师的意见与建议:
1、对尚未触发的可疑记忆,应核查来源权限、越权风险及规则冲突。高风险记忆先隔离,存疑记忆限制使用并交由人工复核。
2、建议统一攻击与防御相关研究的分析口径,明确现有方法的局限,并通过同类方案对比说明自研方案的价值。
3、攻防实验流程较完整,建议结合统计结果说明各项防御目标是否达成,并分析不同防御措施对正常任务的影响。
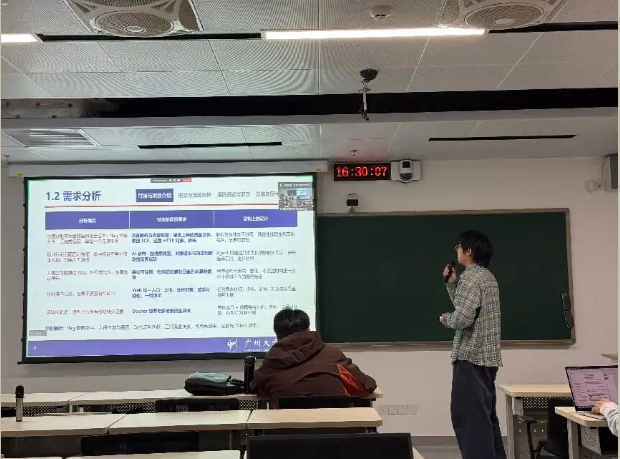
第四位报告人:丁泽恩
报告题目:TraceLab:基于 LLM 的恶意流量分析 Agent 系统设计与实现
点评老师的意见与建议:
1、项目整体思路清晰,将程序解析、规则研判与 Agent 调查相结合,对Agent的作用与局限分析较为客观,完成度较高。
2、需加强数据安全设计,原始流量包及提取对象不宜直接下载,建议将解析结果存入数据库,以在线检索替代下载,并增加权限与审计。
3、PPT整体内容完整,演示界面可进一步丰富分析结果的展示,验证部分应在最后归纳并明确给出结论。
第八组
第一位报告人:郭峻豪
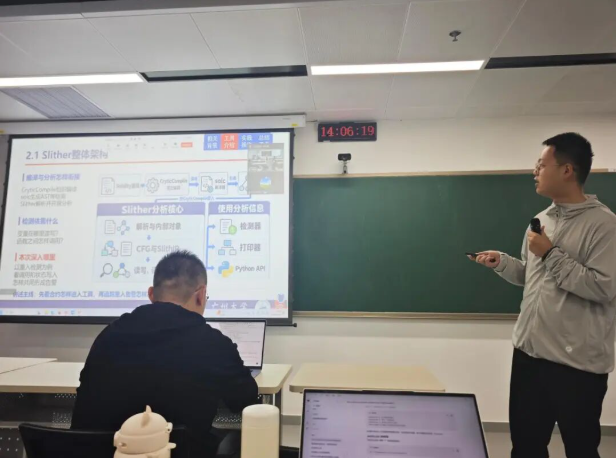
报告题目:Slither智能合约静态分析
点评老师的意见与建议:
1、建议引入公开数据集或benchmark,在多个样本上测试,统计误报和漏报,说明工具的检测效果和适用范围。
2、在背景部分补充AST、CFG和IR的作用,讲清源码如何转换为可分析的表示,以及为什么需要IR。
3、结合影响程度、函数可达性和权限限制筛选告警,再由人工核对业务逻辑,修复后用工具复查。
4、在源码解读的基础上,熟悉工具的开发接口,尝试编写符合业务需求的检测规则,并结合真实案例验证。
第二位报告人:崔子乐
报告题目:使用 Neo4j 与 LangChain 实现"从本地到全局"的 GraphRAG
点评老师的意见与建议:
1、自研了一个最小实现,走 Neo4j + LangChain 路线,把微软 GraphRAG的全链路完整走通,并且用同一份语料和微软官方做了对比,还对参照和错题做了归因。
2、实验只统计了准确率,在企业视角下,只有准确率,还不足以支持决策。还要看系统构建耗时、大模型费用、提问响应时延等成本。
3、结论的统计支撑不足,对比的题库只有15 道题,不足以证明方案更优,可以增大检索规模、换用更大规模语料,用更多量化数据支撑结论
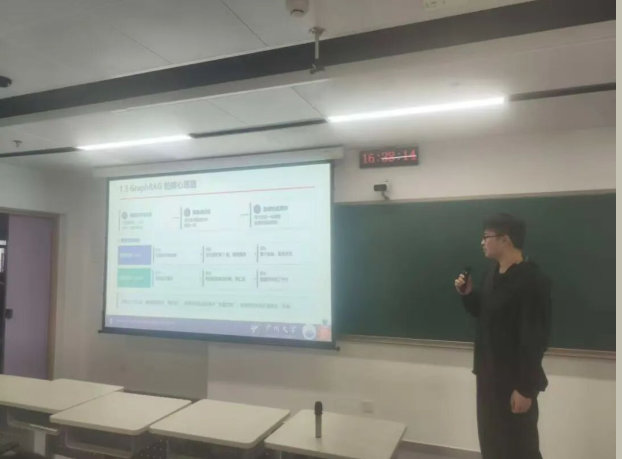
第三位报告人:支小乐
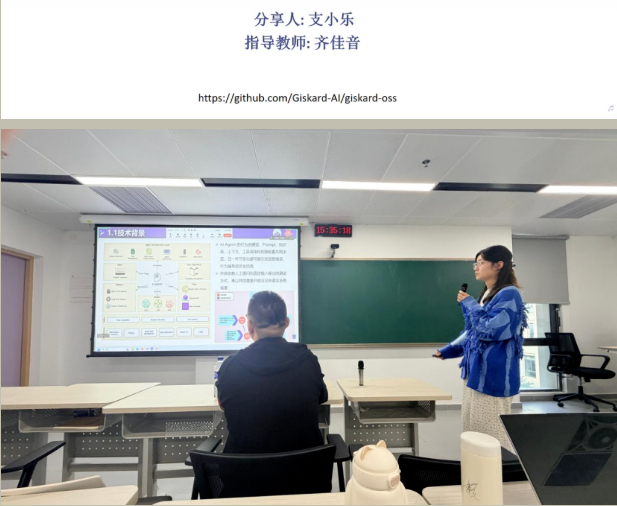
报告题目:基于Giskard的AI Agent安全测试与漏洞扫描实践
点评老师的意见与建议:
1、肯定选题准确抓住智能体评测痛点。分层评测和趋势观察两项原则具有较强工程实践价值。
2、建议聚焦提示注入、越狱等场景生成器,深入分析其生成逻辑、输入因素及风险判定机制。
3、完善竞品与架构分析:将 Giskard 纳入统一对比,明确各模块的输入、输出和交互关系。
4、功能展示应补充自定义场景,并表格化呈现通过率、失败率、耗时及多次运行趋势,突出结论。
第四位报告人:尹洁
报告题目:TenSEAL张量同态加密库
点评老师的意见与建议:
1、实验部分(4.2 节)建议补充明文计算对照。第三、四组实验的运算耗时虽然较短,但缺少与不加密(明文)计算的基准对比,难以直观体现同态加密带来的实际开销,实验结论的说服力不足。建议补充同规模明文运算的耗时数据作为对照。
2、建议增加“AI 工具使用”相关内容。汇报中应说明在哪些环节使用了 AI 工具、具体使用了哪些工具,以及如何对 AI 生成或辅助完成的内容进行验证与核校,以体现研究过程的严谨性。
3、建议适当延伸与拓展应用场景。受汇报时间所限,当前内容主要集中于 TenSEAL 库本身的介绍。建议在时间允许的情况下,结合具体应用场景(如隐私保护的机器学习推理等)进行适当延伸,以更充分地体现项目的实际应用价值。