
第126期方班演武堂成功举办
第126期方班演武堂成功举办
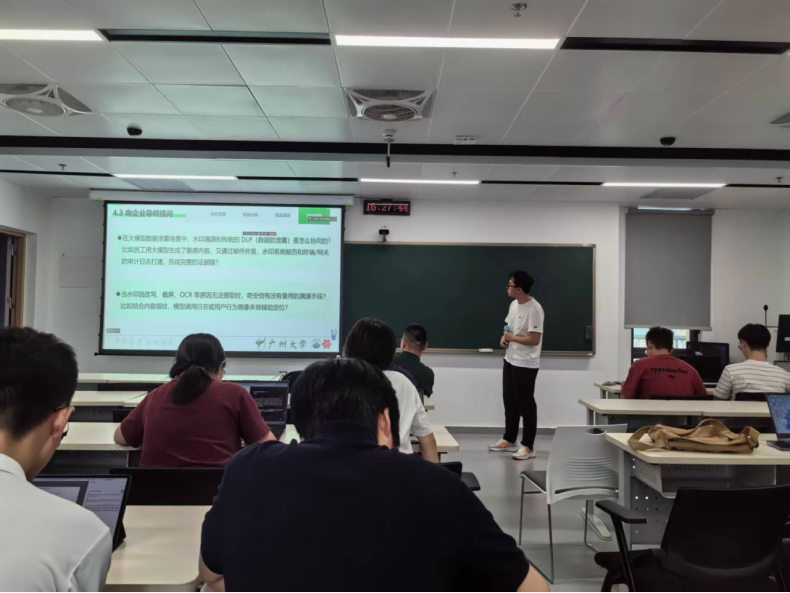
2026年10月13日14:00-17:30,第126期方班演武堂在广州大学黄埔校区B2栋博信楼成功举办,绿盟班、海康班、天融信班、安天班、任子行班、启明星辰班、安恒班、奇安信班8个企业冠名教学班的企业导师,以及方班九期全体学生和网安学院部分老师参与了课堂教学。
本次演武堂课程分为八个教学班。绿盟班(1班)汇报的同学是吴广泉、吕楠楠、杨佐志,来自绿盟科技的蔚睿、姚晨、冯凯翔为主点评老师;海康班(2班)的汇报同学是李灿滨、李聪、李雪峰、戴志伟,来自海康威视的周少鹏、陈瑞云、朱德昌为主点评老师;天融信班(3班)汇报的同学是陈囿轩、莫浩境、彭乾坤、黄甜甜,来自天融信的李娇、王日、黄兵华为主点评老师;安天班(4班)的汇报同学是李雪梅、贺紫盈、郑炯祥、李弘玥,来自安天科技的郭洪亮、沈长伟、白淳升、李林哲为主点评老师;任子行班(5班)的汇报同学是李诗怡、黄仁杰、林志煌、周汝阳,来自任子行的周邦链、胡涛为主点评老师;启明星辰班(6班)的汇报同学是潘馨悦、邬启发、曾振涛、吴杰霖,来自启明星辰的邬娜、万海军、王硕玮、邢汇芸为主点评老师;安恒班(7班)的汇报同学是王梓涵、杨强顺、陈勇良、黎益有,来自安恒的郭廓、曾盈、陆淼波、陈凯为主点评老师;奇安信班(8班)的汇报同学是吴甘融、周子扬、李萍、张玙璠,来自安恒的黄传明为主点评老师。
第一组
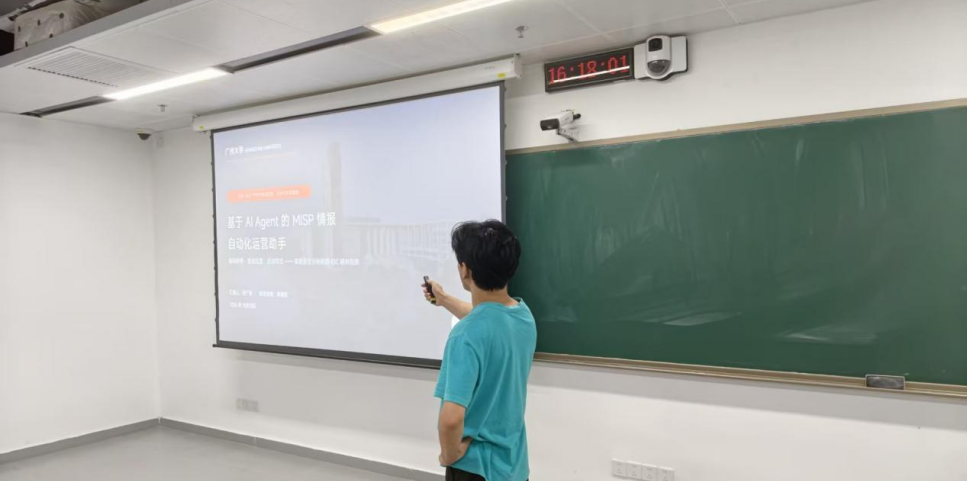
第一位报告人:吴广泉
报告题目:基于AI Agent的misp情报自动化运营助手
点评老师的意见与建议:
1、内容完整,模块清晰,条理很清楚。
2、竞品选择不是很恰当。
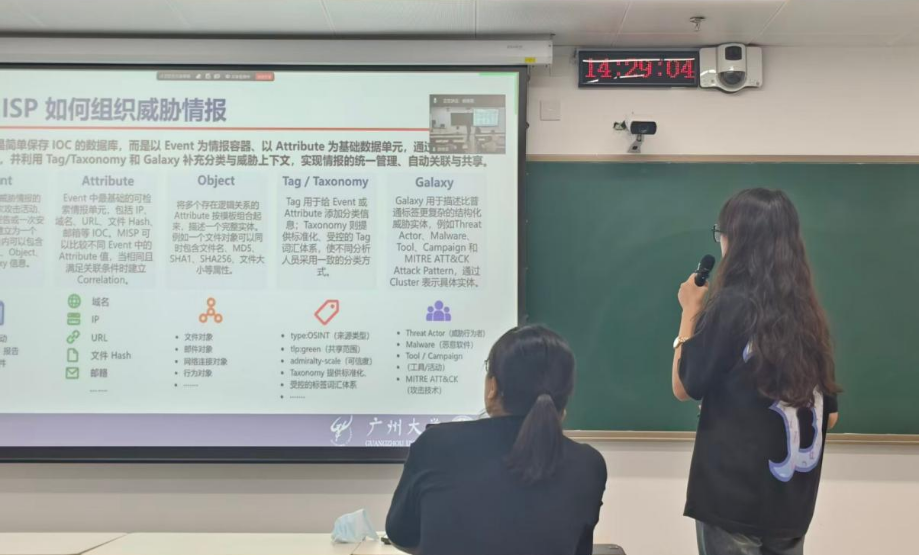
第二位报告人:吕楠楠
报告题目:MISP开源威胁情报平台部署与情报共享实践
点评老师的意见与建议:
1、现有工作偏基础部署与官方源使用,应拓展CVE、OTX、Abuse.ch等多源情报,完善数据映射、清洗及异常处理。
2、补充技术选型依据、性能与运维方案,深入分析数据库表结构、模块组织及核心代码调用流程。
3、完善情报降噪排序和多维共享权限控制,增加竞品对比,精简概念性内容,突出与已有工作的差异。
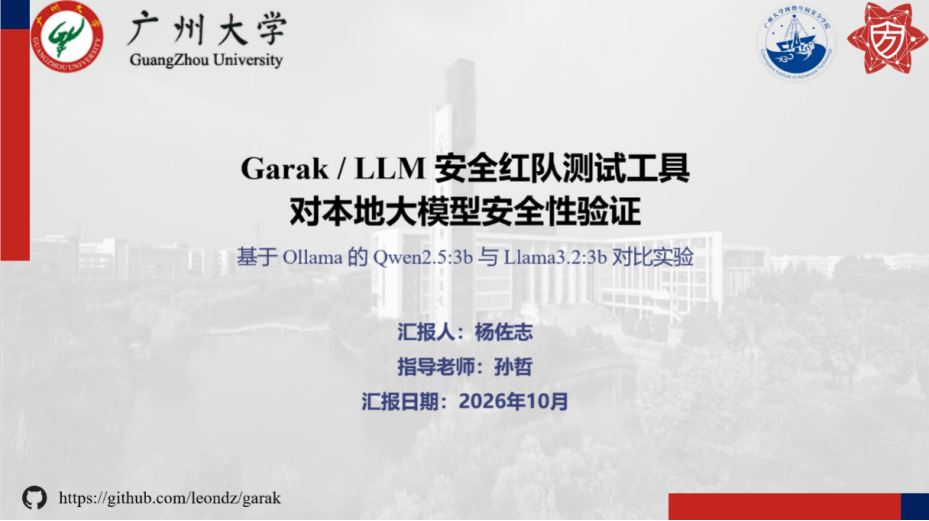
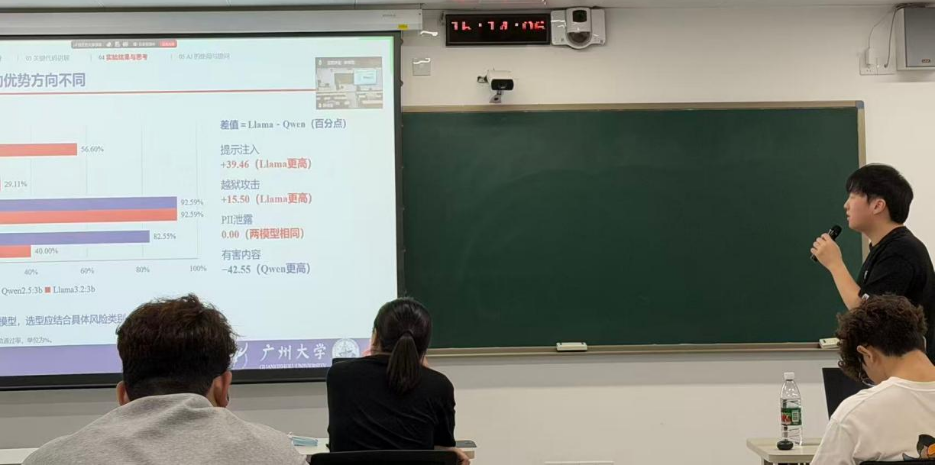
第三位报告人:杨佐志
报告题目:Garak/LLM安全红队测试工具对本地大模型安全性验证
点评老师的意见与建议:
1、实验完成度较高,模型差异展示清晰。建议分类分析误报,并考虑用模型辅助判定回答的安全性。
2、建议将红队测试纳入CI/CD发布门禁,按风险类型设置攻击成功率阈值,持续检测与修复。
3、建议明确攻击类型与探针的关系,并结合实例解释检测轮次、模型输出及JSON关键字段。
4、建议补充竞品分析,结合现实需求比较同类工具的功能特点与适用场景。
第二组
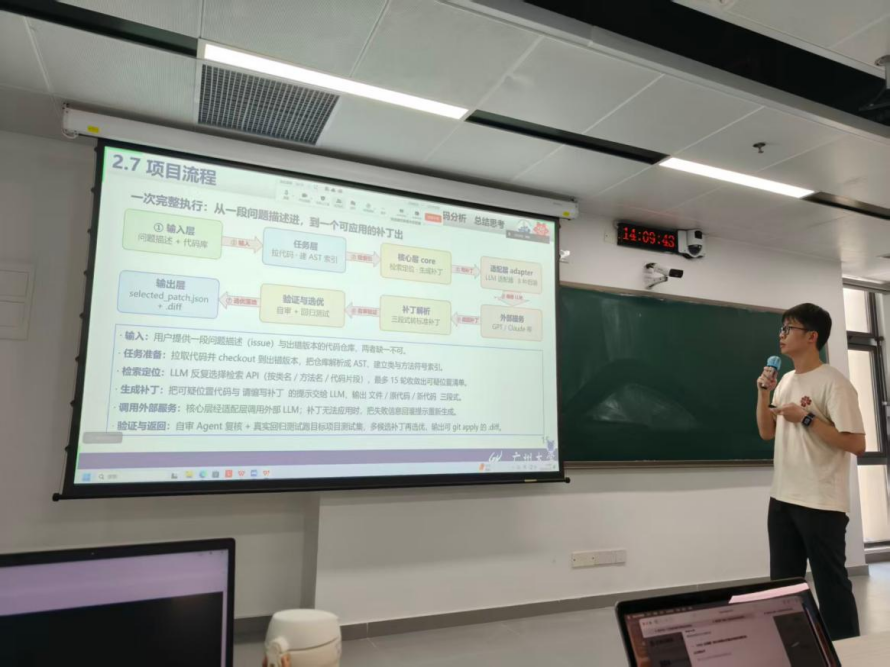
第一位报告人:李灿滨
报告题目:AutoCodeRover:大模型自动程序修复智能体
点评老师的意见与建议:
1、大模型辅助程序修复具有实际应用价值,但在大型企业中,代码仓库规模庞大且可能涉及私有代码,需要结合企业实际开发环境考虑落地方案。
2、企业软件修复不仅涉及代码修改,还需要经过测试验证、人工审核等环节,不能完全依赖智能体自动生成的补丁。
3、应将自动化程序修复工具与企业现有研发流程相结合,建立规范的代码修改、测试和人工确认机制,提高实际应用的可靠性。
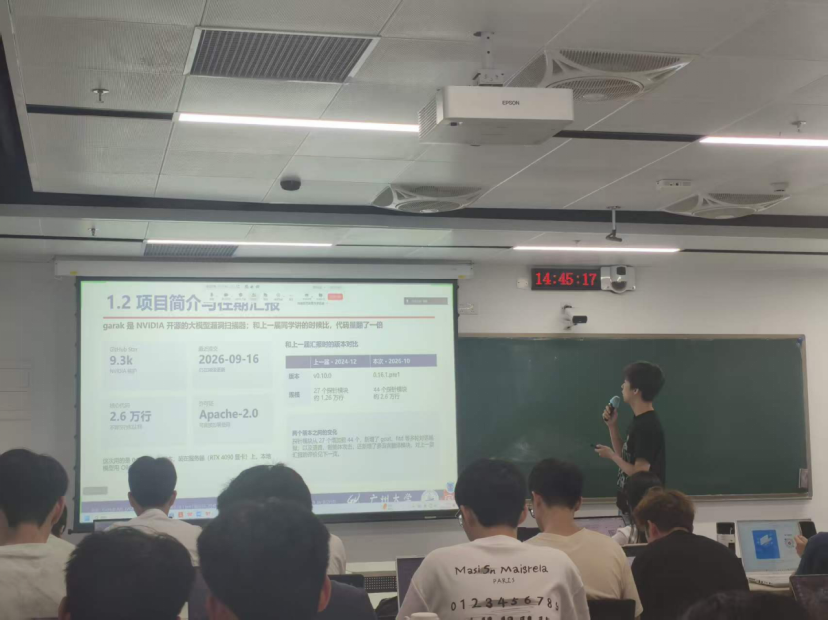
第二位报告人:李聪
报告题目:garak大模型漏洞扫描器:架构剖析与判定准确性实测
点评老师的意见与建议:
1、判定不能只依靠单一规则或单一大模型,实际应用中一般采用分层过滤:第一层用正则和关键词快速初筛以节省成本,第二层用 BERT 等小型分类模型过滤,复杂情况再交给大模型裁判甚至人工判定,同时要把打分指标量化清楚。
2、针对模型“装糊涂”或被绕过的情况,只测单轮对话难以防住,很多安全漏洞是通过多轮对话诱导出来的;实际落地需要依靠模型的思维链(CoT)稳固防护逻辑,测试时也应将静态规则与动态多轮攻击结合起来。
3、汇报逻辑和 PPT 结构需要调整,系统演示不宜放在最前面,应先讲清底层架构和代码逻辑,再进行实操演示;另外,抽样复查(如按 5:3 抽样)需要说明科学依据和置信度,不能凭感觉随意抽取。
第三位报告人:李雪峰
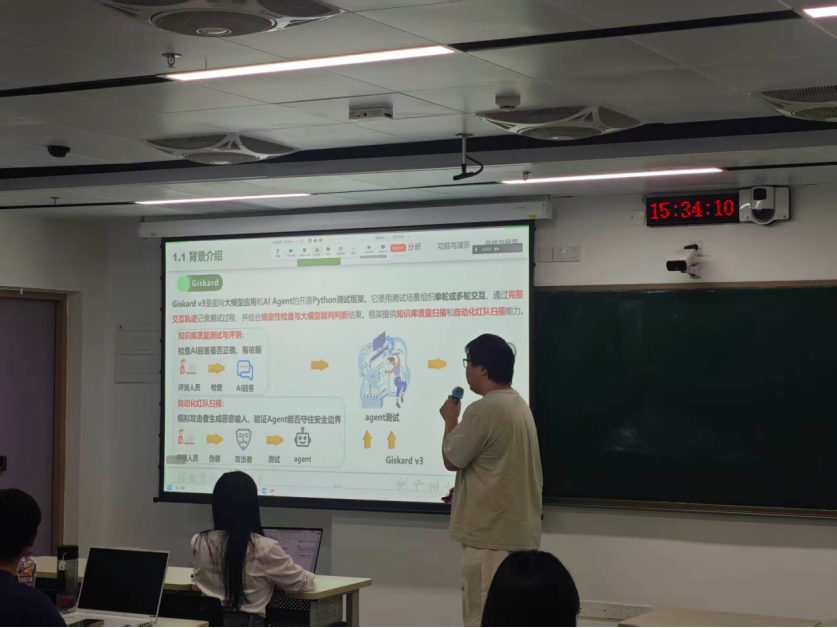
报告题目:Giskard:大模型测试与扫描框架
点评老师的意见与建议:
1. Discord 呈现出庞大且较完善、专门用于审计Agent的体系。
2. 代码函数之间的调用展示的比较清楚。
3. 代码输入、代码执行流程图、代码映射以及函数和整个项目流程的输入输出在展示中缺失或未讲清。
4. 项目最终输出是测试报告,导师指出后面分析时没有展示报告。
第四位报告人:戴志伟
报告题目:Promptfoo大模型红队测试平台
点评老师的意见与建议:
1. 建议先介绍该项目,在介绍背景,但是有自己的逻辑也可以,先介绍背景在介绍项目也可以。
2. 项目做了很多的测试,测试范围较广,项目背景分析到位,代码执行原理解析详细,总体思路和模型框架明确,但是大模型之间应该互相评,不能用单一的大模型。
3. 代码的框架内容较少,源码分析的内容较少。
第三组
第一位报告人:陈囿轩
报告题目:TextAttack NLP对抗攻击框架
点评老师的意见与建议:
1、实验设计应明确对比配方的组件差异,并围绕需求验证框架性能,避免分析空泛。
2、竞品分析与架构设计须紧扣前期凝练的需求,确保功能模块与需求对应,逻辑连贯。
3、代码讲解宜结合实例展示数据流转过程,减少术语堆砌,提升直观性与理解度。
4、总结框架局限性(如贪心搜索缺陷)需补充实验证据,增强结论说服力。
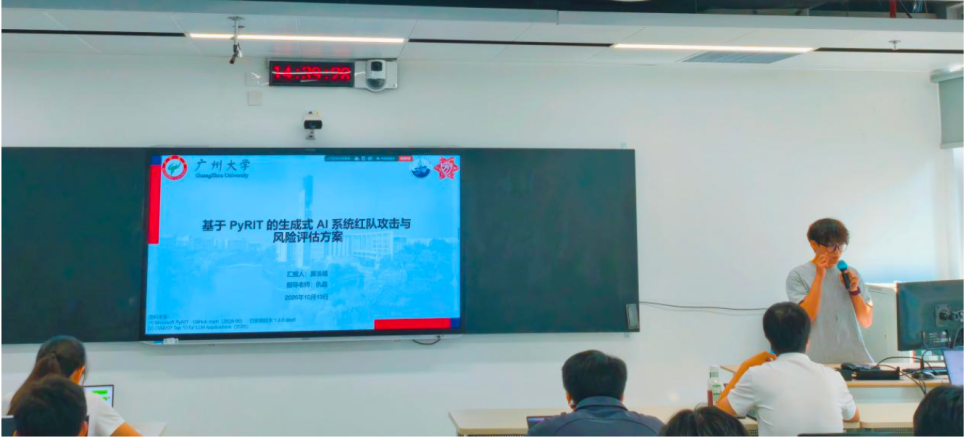
第二位报告人:莫浩境
报告题目:基于PyRIT的生成式AI系统红队攻击与风险评估方案
点评老师的意见与建议:
1、实验仅使用单条样本开展测试,样本数量过少,缺少多次重复实验;工具包含多种攻击策略,但仅展示了部分策略结果。
2、没有使用工具自带评分器,关键词匹配效果有限,建议采用大模型做判定,如果要用关键词方案,需要在实验过程持续迭代、收集人工标注数据集来优化判断规则。
3、不建议脱离完整业务流程,孤立罗列各个功能模块的作用,展示的函数执行流程图不是完整端到端流程,缺少参数构造环节,整体工作流程图绘制质量较好。
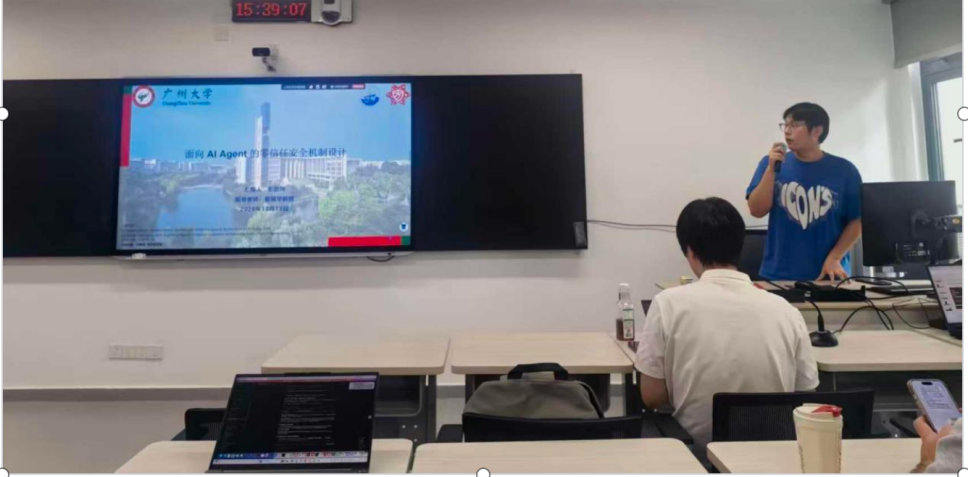
第三位报告人:彭乾坤
报告题目:面向AI Agent的零信任安全机制设计
点评老师的意见与建议:
1.架构图中安全控制层与任务工具调用层关系需厘清,请求预处理与访问解析存在重叠,建议参考成熟零信任架构重整。
2.风险评分中任务一致性等分值来源、策略库写入方式需说明,当前偏人工规则,缺少意图检测,策略最优性待验证。
3.企业多步任务下动态决策性能开销、行为日志增长与存储优化需进一步考虑,并给出可行方案。
4.当前工作偏简单原型,产品化与接口设计不足。
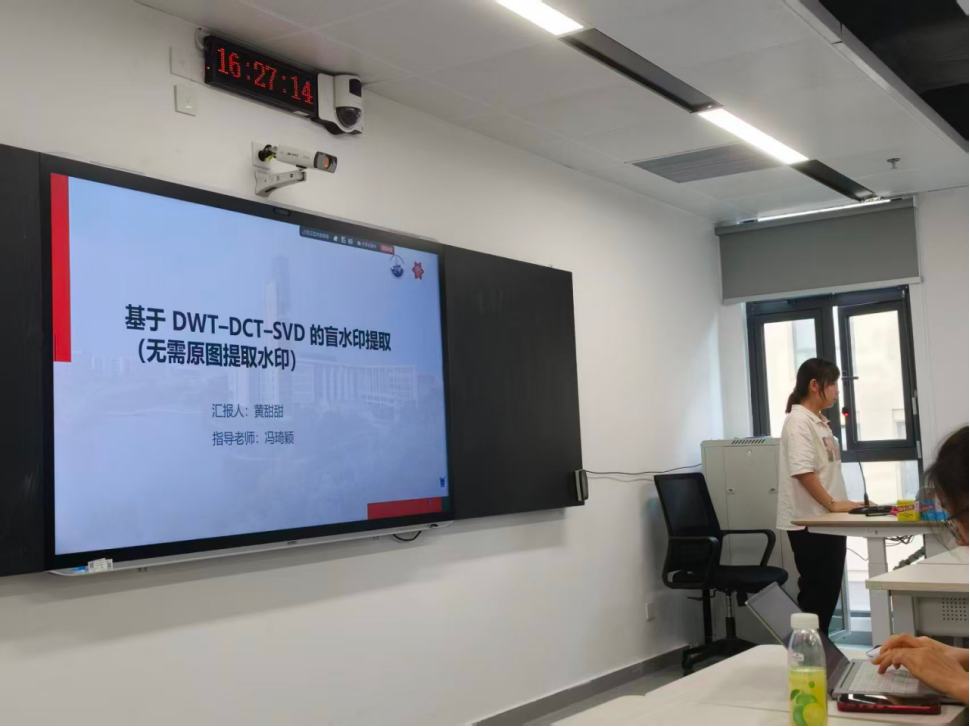
第四位报告人:黄甜甜
报告题目:基于DWT-DCT-SVD的盲水印提取
点评老师的意见与建议:
1、可以结合其他开源项目进行实验。
2、可以多比较其他开源项目,加入实验展示中。
第四组
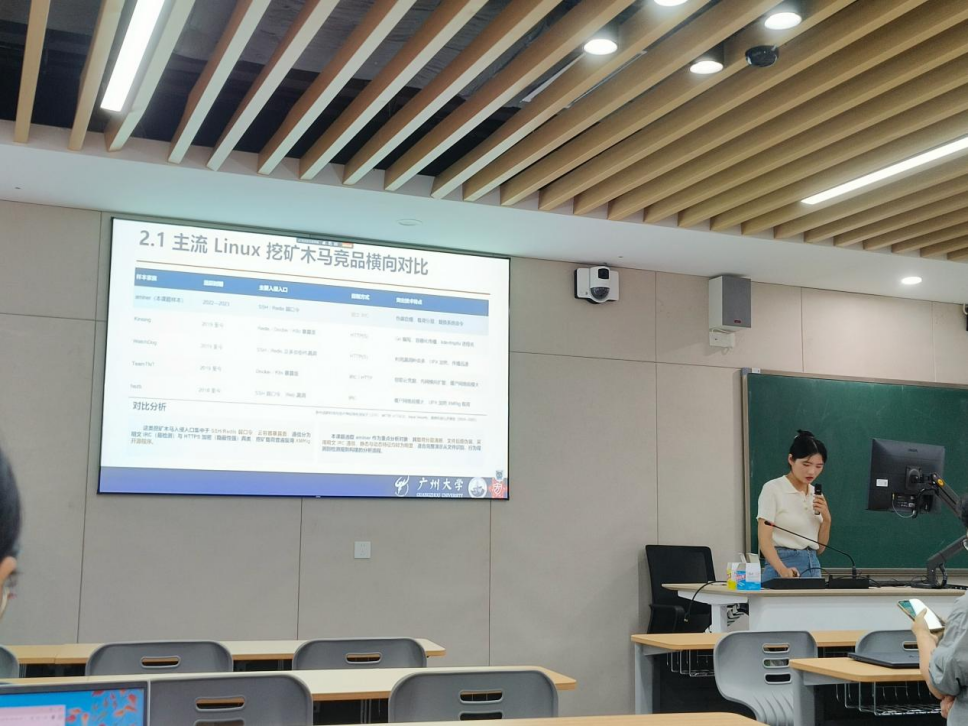
第一位报告人:李雪梅
报告题目:aminer
点评老师的意见与建议:
1. 补充检测失败漏报案例,建议放真实环境测误报;处置流程需体现删服务、杀进程、断矿池的先后顺序。
2. 汇报目的不明确,需带着问题讲;要说明新木马如何定位C2、发现隐藏进程,以及恶意DNS的判定依据。
4. 分析不能只停留在抓包和CPU观察,要给出具体判断指标。
第二位报告人:贺紫盈
报告题目:基于AI Agent的MISP情报自动化运营助手
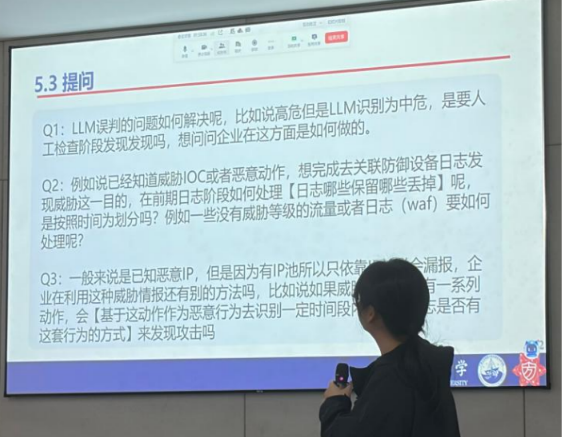
点评老师的意见与建议:
1、深化同类产品调研,明确项目目的与应用价值,重点说明情报关联等核心难点及实现方法。
2、明确数据来源、格式与解析流程,完善异构数据接入,保障输入数据和研判证据的准确性。
3、优化用户提示与系统提示,结合schema约束、输出校验和幻觉控制,提高研判结果的稳定性。
4、加强可信情报的结构化积累,按风险等级制定保留策略,依据新事件持续更新 IOC 状态与有效性。
第三位报告人:郑炯祥
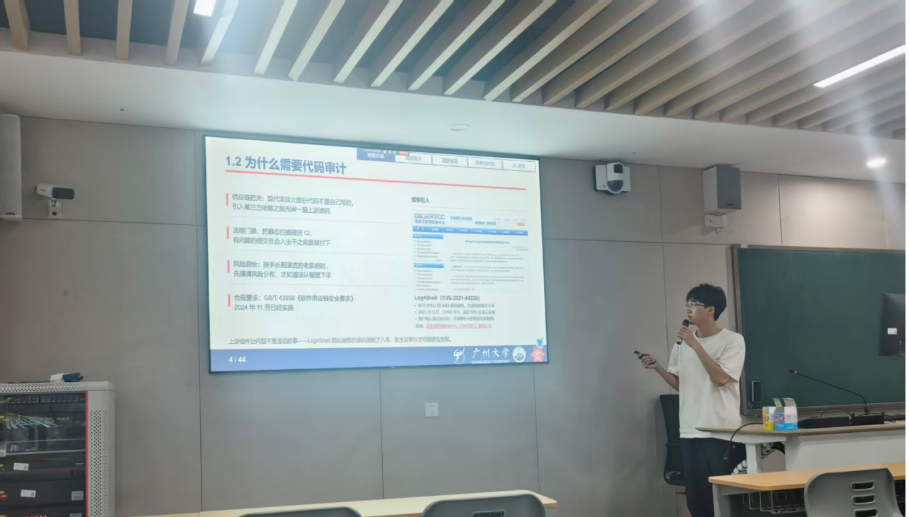
报告题目:Semgrep与CodeQL代码审计实战——对两个开源项目的安全扫描与分析
点评老师的意见与建议:
1、项目立足实践,以具体样例开展验证,工具选型互补、搭配合理。2、项目补丁完成后需再次审计,确认未引入新漏洞;扫描可聚焦补丁部分,前置审计可由他人完成。3、项目中漏报危害高于误报,漏报会带来严重后果,误报仅增加人力成本;可借助大模型分析误报,持续优化项目。
第四位报告人:李弘玥
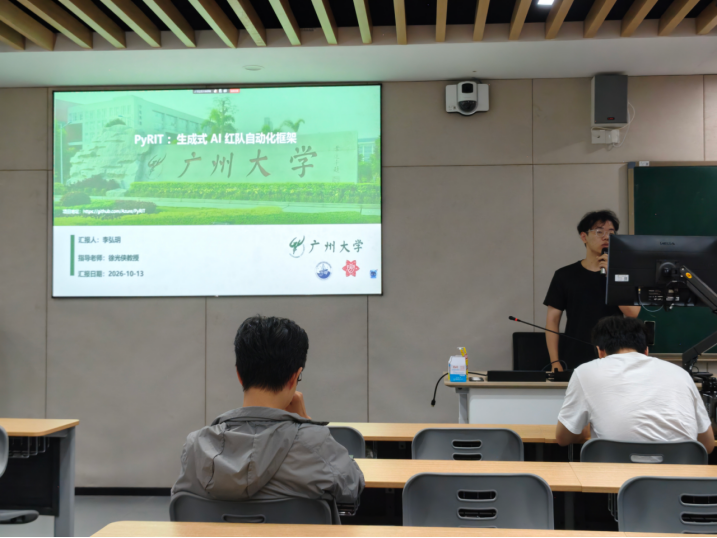
报告题目:PyRIT:生成式AI红队自动化框架
点评老师的意见与建议:
1、该选题比较新,后续可以扩充测评测试数据集,建议增加引入例子和动机事例,说明为什么要做这件事,类似写论文要有动机事例。
2、测试目标对比了两个,如何评价它们是否都达成测评目标,对比是否公平,敏感信息如何注入、泄露提示是什么、结论是否一致,这些都可以发散讲解。
3、PyRIT支持接入专用分类器作为评价标准,外围做安全护栏是可能的发展方向。建议继续深入,该领域非常有价值。
第五组
第一位报告人:李诗怡
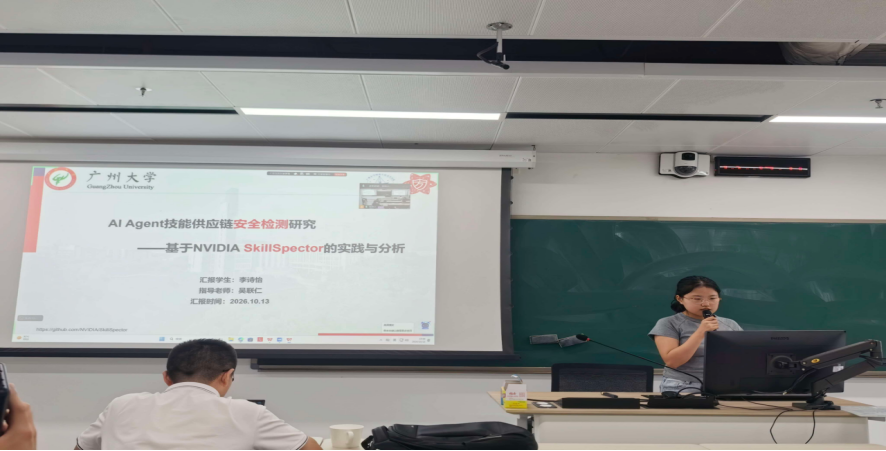
报告题目:AI Agent技能供应链安全检测研究——基于NVIDIA SkillSpector的实践与分析
点评老师的意见与建议:
1、老师认可了选题的前瞻性,但样本量小、匹配率缺统计显著性,建议抓取真实市场大规模样本,补充精确率、召回率与误报率。
2. 代码讲解已有基础,需从功能描述升级到机制归因,深入分析设计意图、模块关系与边界条件,说明“为何这样设计、何时有效”。
3. LLM策略方面建议先使用本地小模型初筛,仅对可疑或冲突样本按需调用云端大模型,兼顾效果与成本。
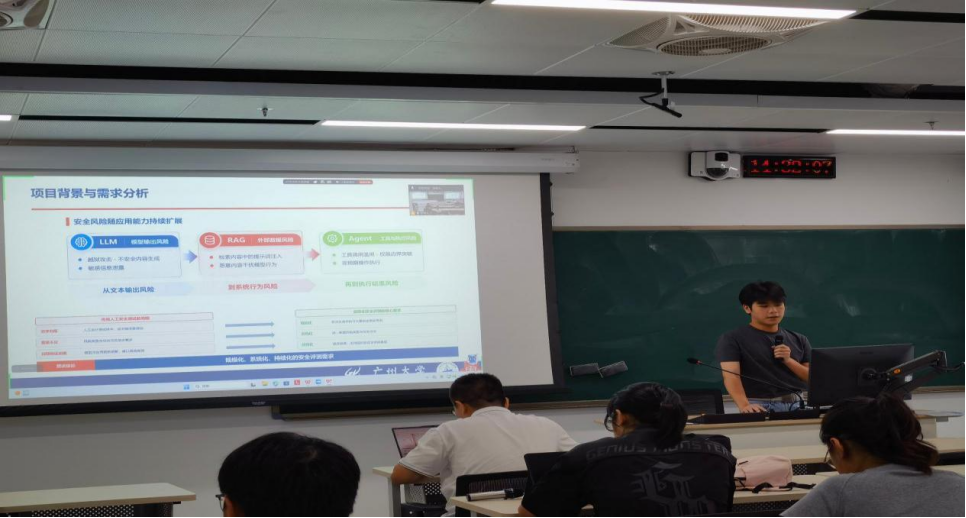
第二位报告人:黄仁杰
报告题目:promptfoo:大模型与智能体的红队测试框架
点评老师的意见与建议:
1、企业选用开源项目,需评估项目适配业务场景,核查开源协议是否支持二次开发,并区分内部自用与对外商用场景。
2、智能体权限可划分低、中、高风险等级,中高风险决策逐级上收,最终由人类完成最终决策。
3、智能体权限与功能的平衡设计,可参考成熟的社会组织架构思路,将其复用至智能体体系构建中。
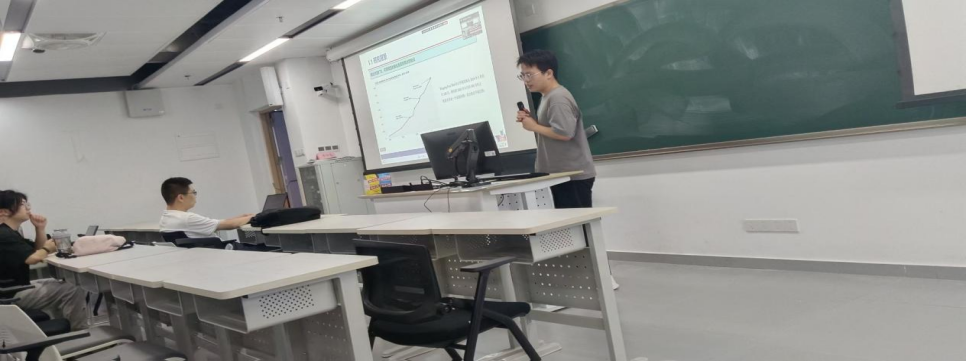
第三位报告人:林志煌
报告题目:garak:一款大模型漏洞扫描工具
点评老师的意见与建议:
1、实际运行工具后,能对检测结果中的异常继续追查并验证,发现输出截断和拒绝短语匹配不全等问题,体现了独立思考。
2、扫描结果可能存在误报,应先人工复核,再按风险类型和严重程度分类,将确认有风险的样本纳入回归测试。
3、建议补充整体架构图和流程图,说明各模块之间的调用关系与数据流转,使代码分析更清楚。
4、应单独说明AI在项目研究中的使用情况,交代其在代码解读和实验分析等环节的具体作用。
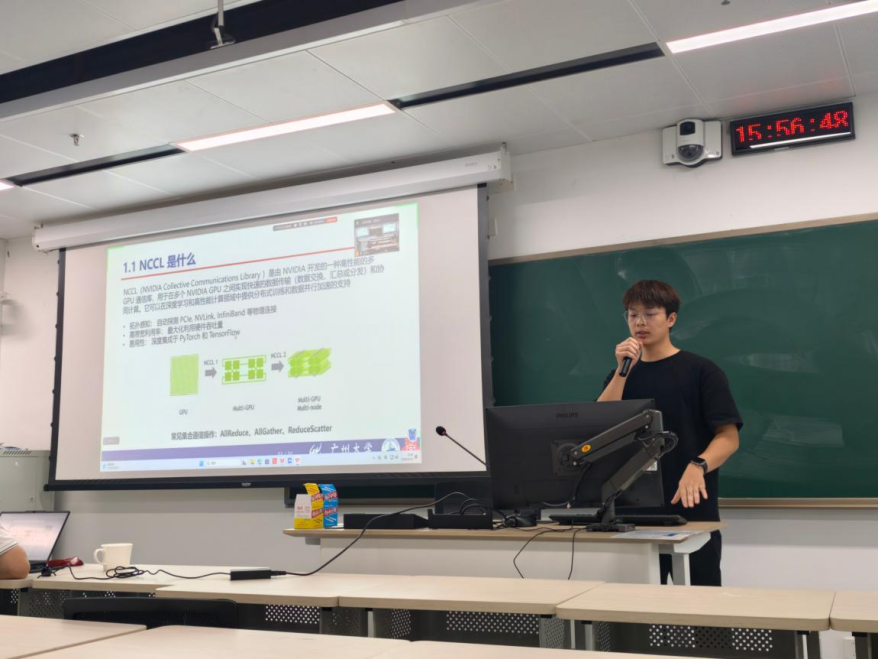
第四位报告人:周汝阳
报告题目:NCCL集合通信库中的GPUDirect P2P机制分析与实验验证
点评老师的意见与建议:
1、项目背景分析和项目中的各类框架、架构图明确,方便大家理解这类问题的背景和偏底层硬件的知识。
2、本次展示中仅展示了部分代码,项目代码实现部分讲解占比偏少。
3、建议增加代码讲解以及在讲解代码的基础上拓展更多相关实验内容,增加实验验证的讲解,补充测试部分进行展示。
第六组
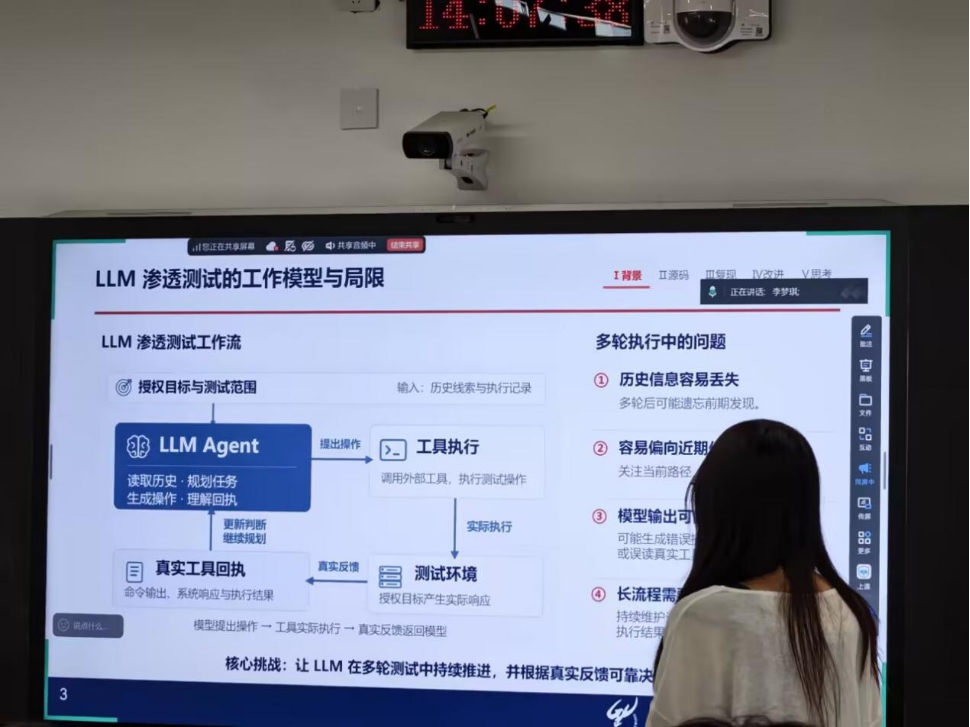
第一位报告人:潘馨悦
报告题目:PentestGPT——由大型语言模型驱动的自动化渗透测试智能体框架
点评老师的意见与建议:
1、项目研读深入细致,论文及多个历史版本的代码均逐一分析对比,前期调研工作扎实,对项目的理解较为透彻。
2、项目整体逻辑清晰,但需核实恢复函数的作用层级与底层实现,并完善项目基本信息、规范术语表述。
3、验证环节需补全靶场环境、测试输入输出及与原项目的对比结果,突出验证过程与结论。
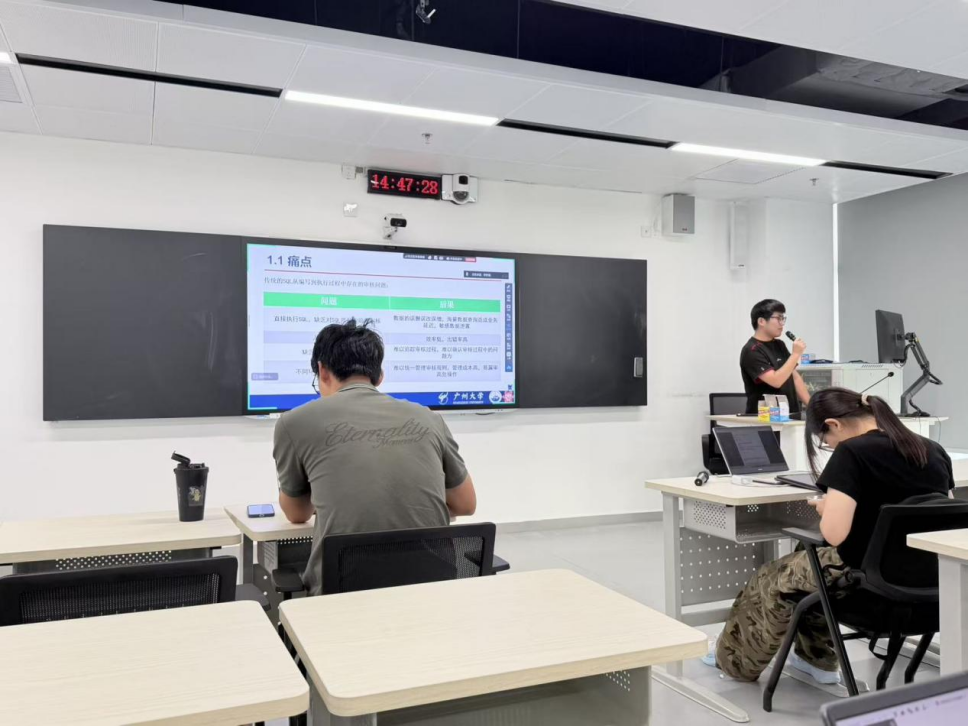
第二位报告人:邬启发
报告题目:Yearning:基于Go与Vue开发的SQL审核平台
点评老师的意见与建议:
1、背景与竞品需更加突出项目与同类产品的核心优势,指明为什么选它,汇报时需要突出项目重点。
2、架构图应该梳理出模块之间的调用关系,汇报的内容要突出与前人所讲内容的差异,自己选这个相关的关注点在哪里。
3、缺乏项目定位方面(如该项目关注的隐私和效率)的验证,强调展示时需把控语速与控场能力。
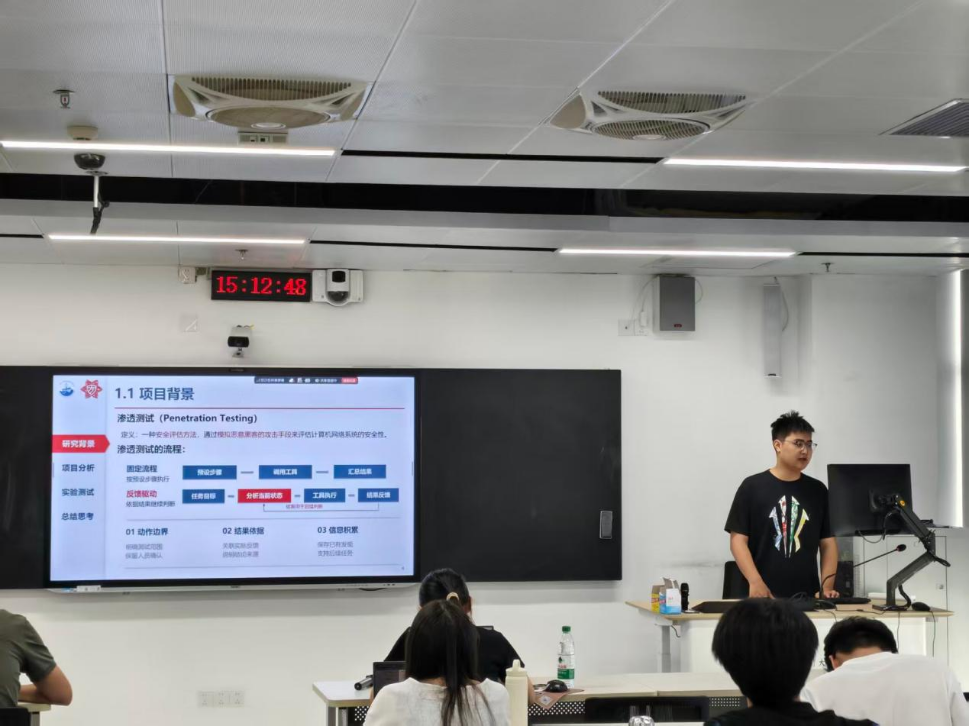
第三位报告人:曾振涛
报告题目:CyberStrikeAI:智能渗透测试平台的运行机制与评估
点评老师的意见与建议:
1、研究逻辑清晰,实验链条与复现过程较完整,体现了较好的实践能力,项目整体完成度高。
2、需进一步串联各模块的对应关系,将执行流程与具体代码接口关联,明确上下游模块的调用关系和数据交接过程。
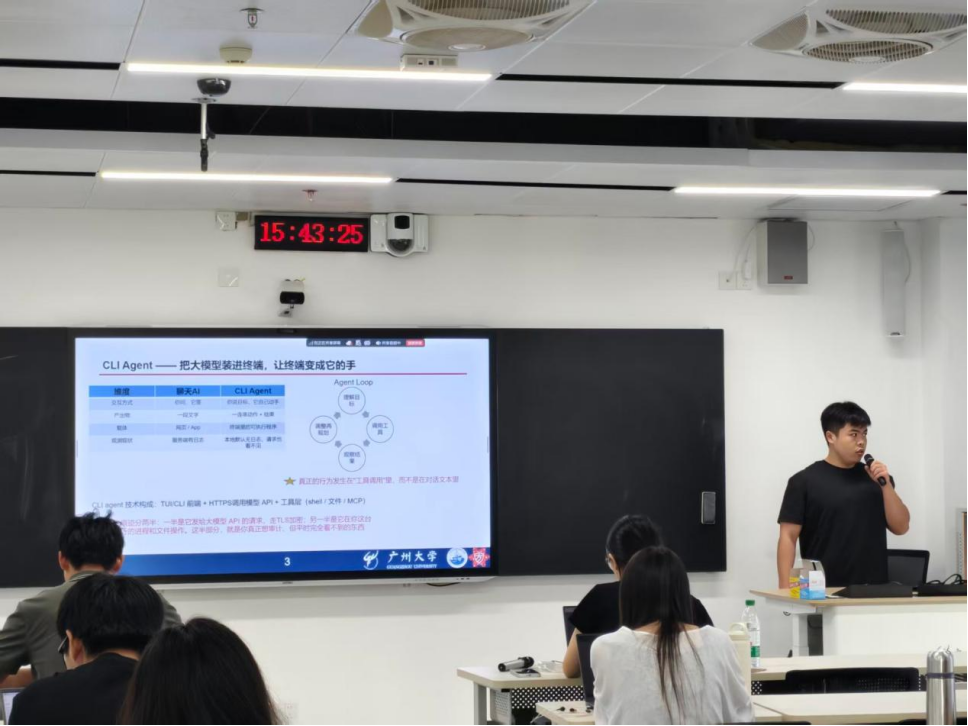
第四位报告人:吴杰霖
报告题目:AgentSight:基于eBPF的零侵入LLM智能体可观测性工具
点评老师的意见与建议:
1.项目介绍部分排版尽量不留空,内容铺满版面,保持整体视觉平衡。
2.项目源码部分字体颜色需要更改,提高对比度,确保投影清晰可见。
3.项目源码部分字体大小和排版要调整,字号加大、行距拉开,避免拥挤。
第七组
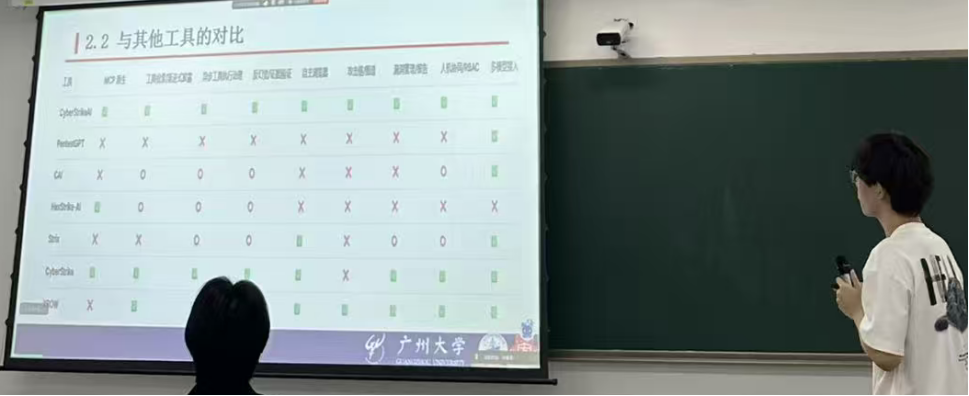
第一位报告人:王梓涵
报告题目:基于AI的自动化渗透系统架构设计实现
点评老师的意见与建议:
1、该项目技术汇报详实,PPT 内容完整。实验部分同时完成靶场与自主实战测试,完成度高;项目总结到位,优化思路深入且符合逻辑。对项目的关键技术原理讲的细致入微,理解到位。总体汇报时间合理,正好满足35分钟。
2、项目背景介绍略显单薄,建议进一步扩充内容,清晰阐释自动化渗透测试的应用价值与现实必要性,帮助听众理解本项目的研究动因。
3、竞品分析部分需进一步优化,重点突出本项目相较于同类方案的差异化亮点,清晰说明项目的核心优势与独到之处。
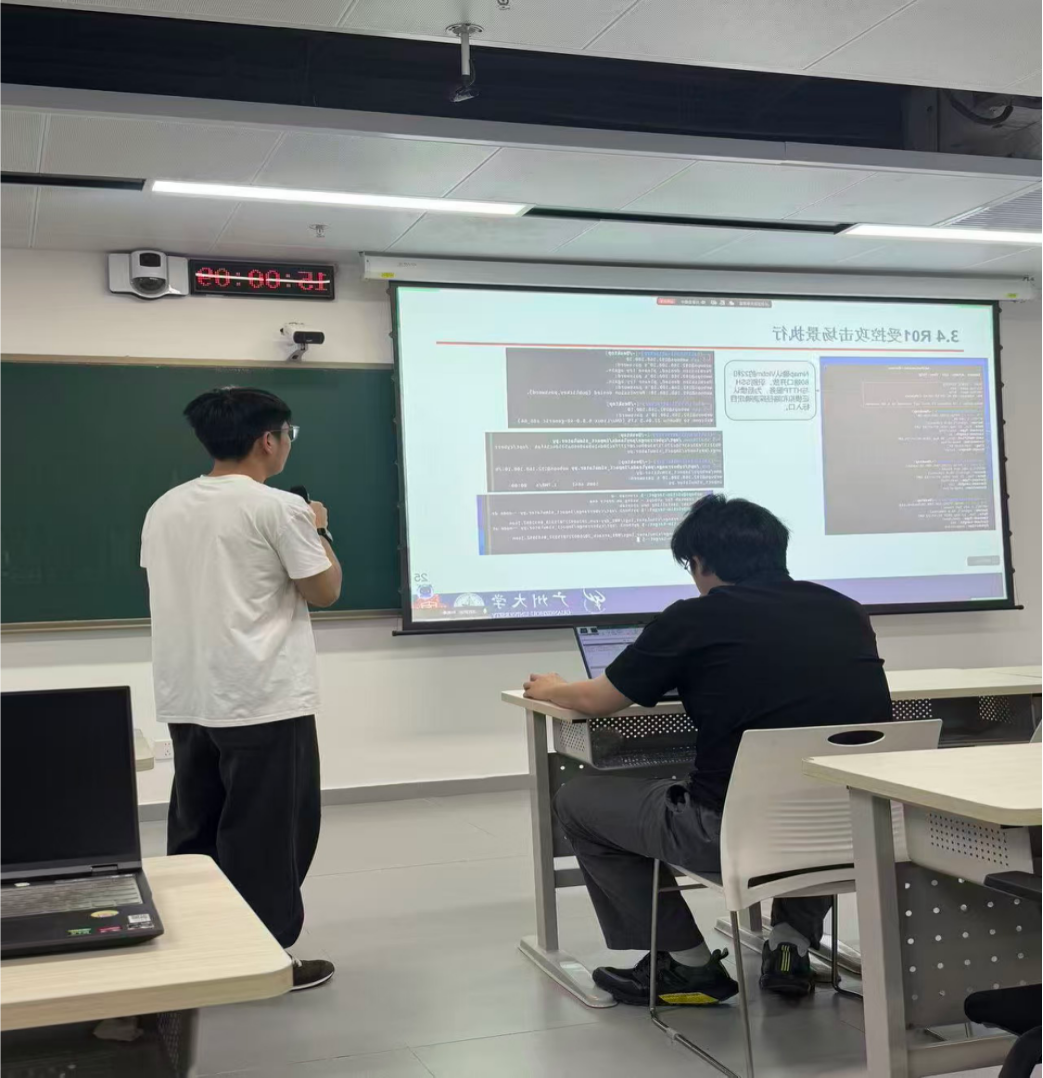
第二位报告人:杨强顺
报告题目:网络安全应急响应综合靶场搭建
点评老师的意见与建议:
1、项目整体完成度较高:能够将应急响应方法论融入靶场设计;应用背景有数据支撑,竞品分析明确,验证过程与结果较充分,能够回应功能需求。
2、明确痛点之间的逻辑关系,完善架构图,补充代码映射图、函数级流程图和关键技术总览;深入分析项目亮点、实际局限及对应改进措施。
3、提升汇报表达与过程展示:适当放慢语速,围绕清晰主线展开,减少照读 PPT,用自己的话解释关键内容;AI 使用部分应展示具体操作与验证过程,不能仅用表格概括。
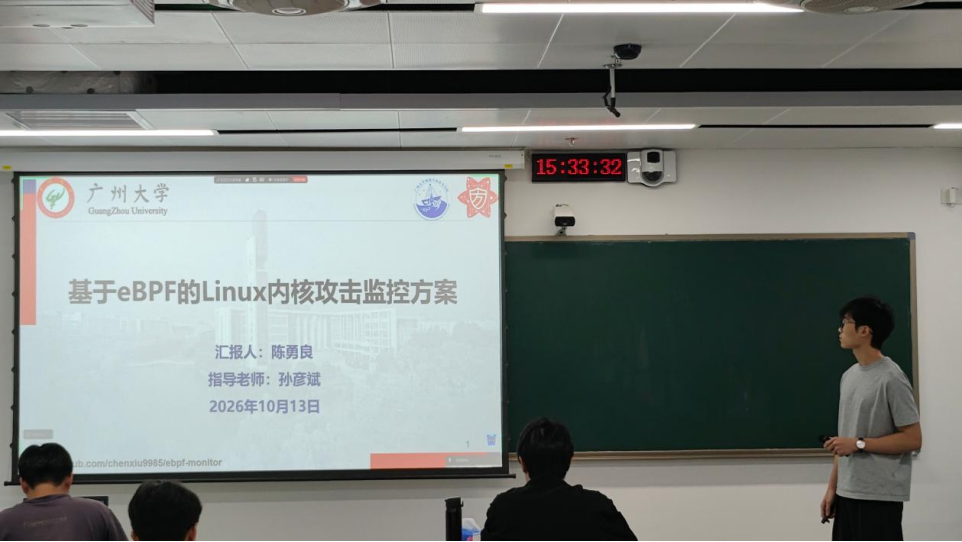
第三位报告人:陈勇良
报告题目:基于eBPF的Linux内核攻击监控方案
点评老师的意见与建议:
1、竞品分析部分要突出本项目相对同类方案的具体优势,比如响应更快、更轻量或更及时,而不只是罗列差异。
2、PPT中应补一页关键技术总览,并补一张函数级流程图,方便后续按函数展开介绍。
3、总结思考页应拆成工程亮点、存在局限性和改进思路三块,局限性部分要写清开销大出现在哪一段链路、什么场景会误报或漏报,并给出失败案例。
4、AI辅助开发部分写得过于简单,应补一个完整案例说明提示词如何拆分、生成代码如何验证真实性。
第四位报告人:黎益有
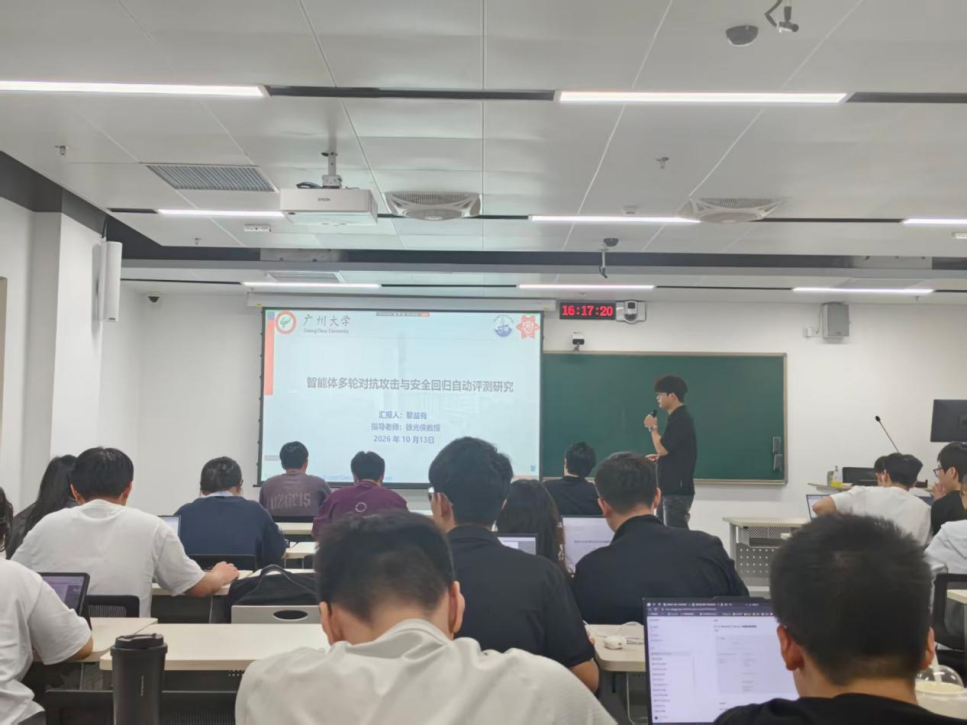
报告题目:智能体多轮对抗攻击与安全回归自动评测研究
点评老师的意见与建议:
1、肯定架构接口模块的内容表述和可视化图示清晰直观,整体完成度符合要求。
2、背景缺“问题→影响→需求”的推导,点出现存问题后应补充其影响和对应功能需求,自然引出后续项目内容。
3、实验验证缺函数级流程图,且没有回应开篇提出的问题,实验结果应逐一论证能否解决对应问题。
4、思考与评价模块除工程亮点和现存局限外,还要补充后续改进方向。
5、AI使用部分不能只口述,要补完整展示过程和正确性验证逻辑。
第八组
第一位报告人:吴甘融
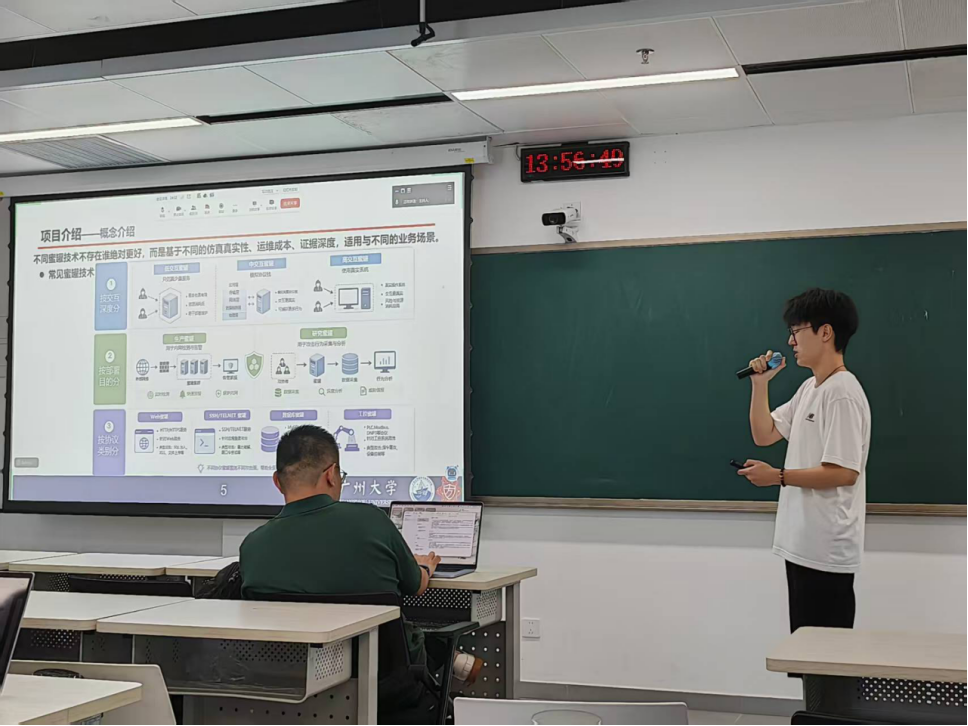
报告题目:Beelzebub:AI驱动的主动欺骗运行时框架分析与实践
点评老师的意见与建议:
1、讲解系统完整,选题恰当,研究有价值,项目完整性好,有试验过程和结果支撑,整体项目有意义和价值;下一步可以从本地测试上升互联网侧,懂互联网获取数据更直接。
2、区分AI智能体的攻击和人为攻击,以及是否可以用beelzebub作为框架,现在大部分东西已经在用AI辅助,或者是甚至AI的自动化攻击,beelzebub可以作为一个框架,低交互可能更多在防护场景,比如企业侧自己部署在内网,因为正常业务不会访问它,低交互的部署在内网,然后把覆盖面扩起来,基本上够用。
3、项目介绍清晰,汇报人对项目了解清楚,架构图美观但是应该放第二部分,流程及讲解过程具有逻辑性。概念介绍可以增加主动与被动防御的区别,竞品分析模块应当从同一纬度进行分析,工程亮点可以加强,建议可以加一点例子。
第二位报告人:周子扬
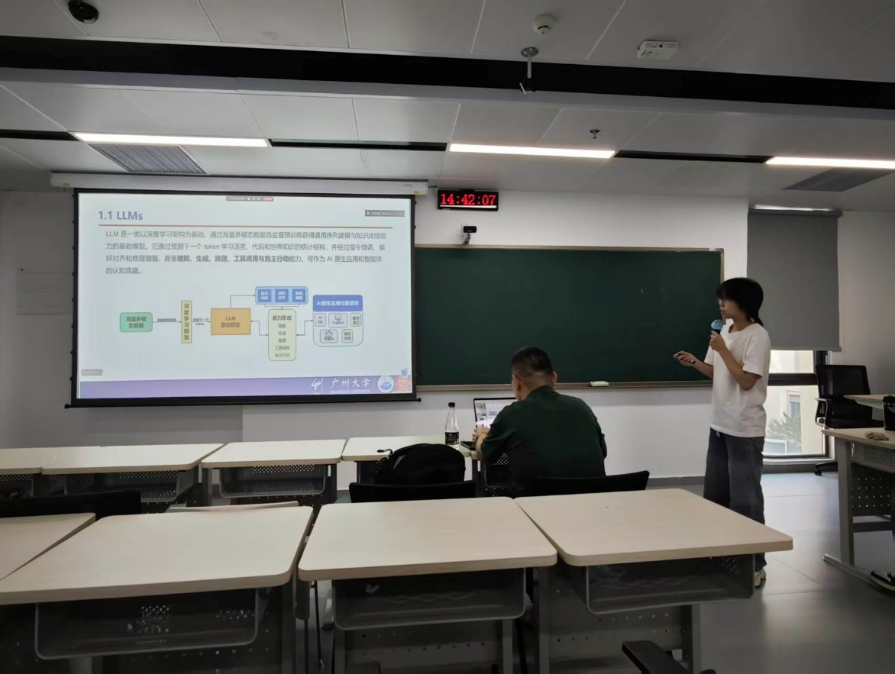
报告题目:Langchain-Chatchat:基于AI大语言模型的本地知识库问答系统
点评老师的意见与建议:
1、项目代码与关键流程分析清晰,效果展示较充分;建议补充查询改写、重排序环节,并参考新兴框架。2、建立带标准答案的测试集,量化评估解析、切分与检索效果;依据业务规则设计追问,细化文档权限。3、代码分析和本地测试较充分;建议理顺背景逻辑,补充总体架构图,明确模块功能与关系。4、加强同类项目对比,明确工程优势;结合具体案例和测试发现,支撑问题提出与未来改进方向。
第三位报告人:李萍
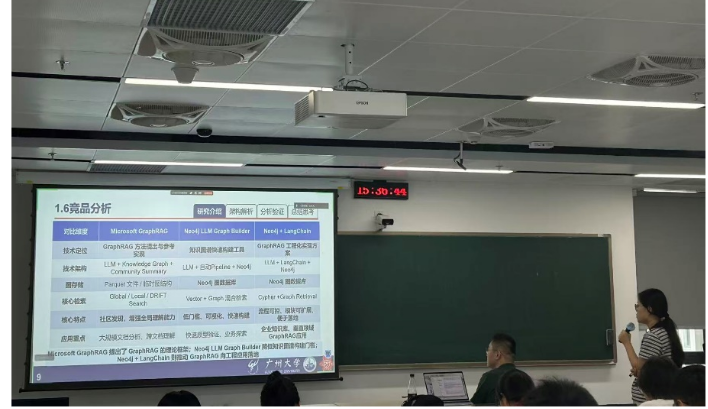
报告题目:使用Neo4j和LangChain实现“从本地到全局”的GraphRAG:构建图
点评老师的意见与建议:
1.方案思路系统,偏向工程落地,具备上线基础,Neo4j、LangChain可支撑亿级数据,十亿级则需分布式图数据库。
2.汇报逻辑完整,已提出实体自动抽取、混合检索、全局检索优化方向,但是Local检索场景传统向量检索有时效果更好。
3.缺少完善的效果评估体系,需要补充图谱质量、问答效果、大模型调用成本效率三类量化评估指标。
第四位报告人:张玙璠
报告题目:MarkLLM
点评老师的意见与建议:
1、该项目是一个清华大学开源的水印架构项目,现在的水印攻击及评测体系有更多的研究可以加上。
2、核心生成信息的闭环目前只能部分闭环,生成目前只能是自然人,企业侧跟这些强相关,水印侧只能作为证据,目前ai训练是主流手段。
3、选题上,不是很好讲,将各种水印进行测试,演武堂要工程性思维,不好做架构图,针对这个题目讲的很不错了,下次可以选工程性强的。
暂无评论
