
示范班第161期方班学术研讨厅成功举办
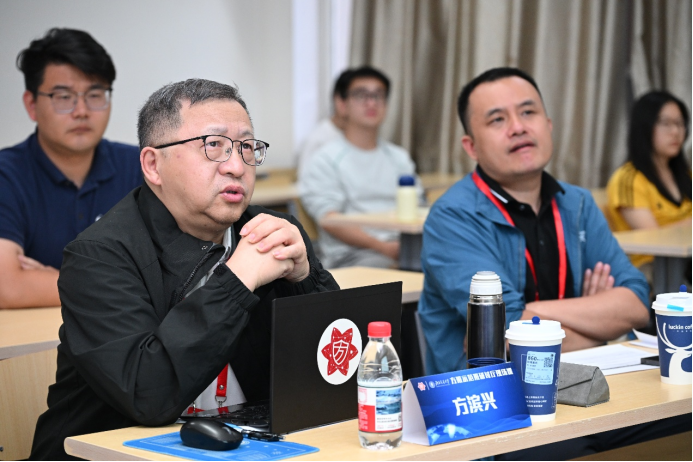
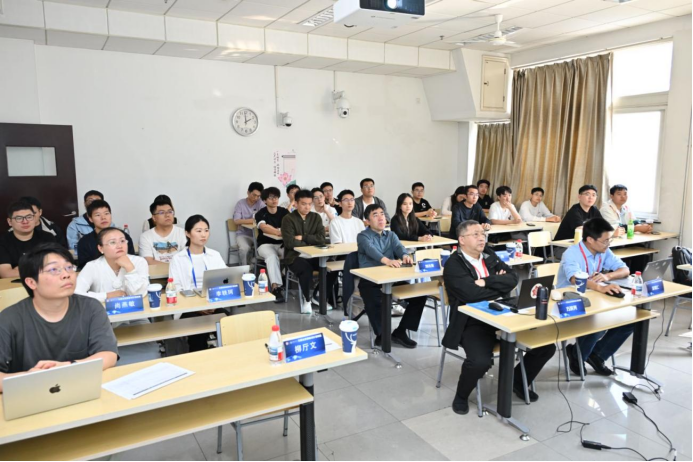
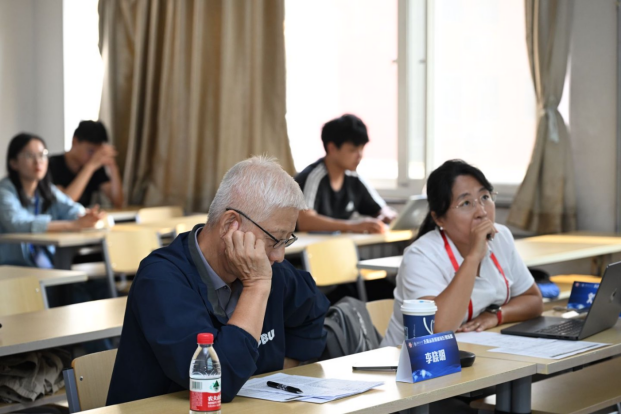
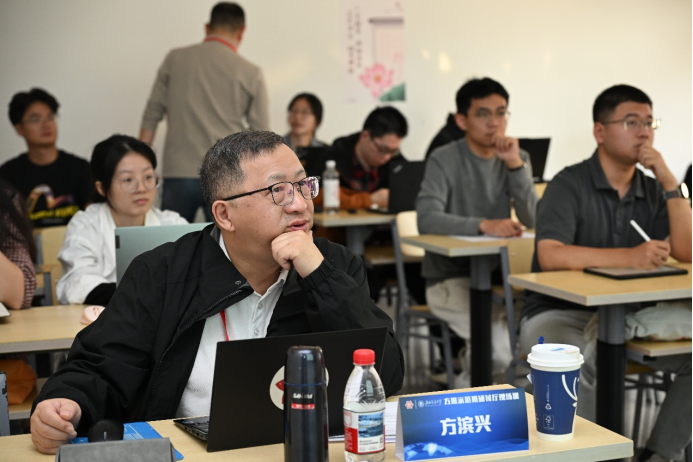
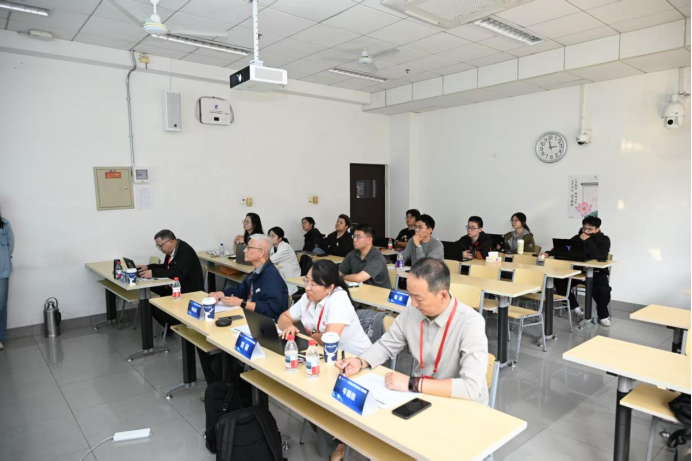
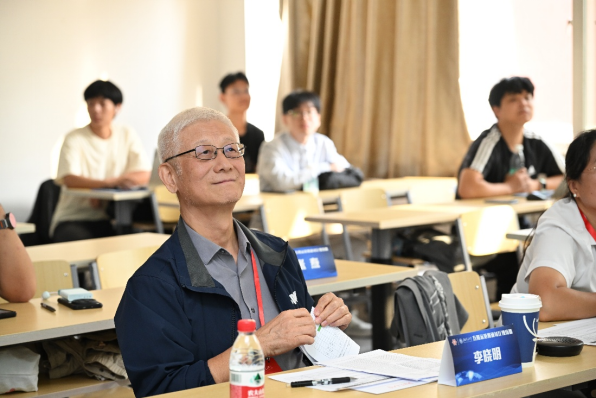
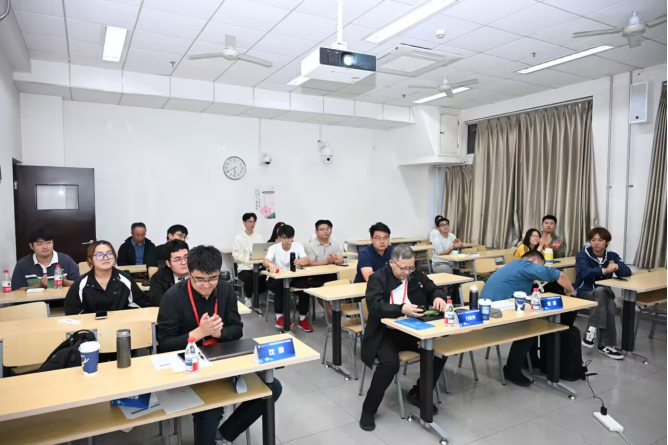
2026年10月11日14:00-17:30,示范班第161期方班学术研讨厅以线上线下结合形式成功举办,线下在北京交通大学开展。方滨兴老师、马建峰老师、贾焰老师、李晓明老师、黄兴忠老师全程参与了课堂教学,并对示范班同学们的报告逐一进行了指导点评。同时参与的还有方班研讨厅四个班级的副点评老师,以及来自广州大学、澳门城市大学、北京大学、北京航空航天大学、北京理工大学、北京信息科技大学、北京邮电大学、大连理工大学、东南大学、复旦大学、广东工业大学、海南大学、湖南大学、华南理工大学、华中科技大学、吉林大学、暨南大学、南京航空航天大学、南京理工大学、南京信息工程大学、南京邮电大学、南开大学、清华大学、厦门大学、山东大学、上海交通大学、四川大学、同济大学、武汉大学、西安电子科技大学、西安交通大学、西北工业大学、香港大学、香港科技大学、香港科技大学(广州)、香港理工大学、浙江大学、中国科学技术大学、中南大学、中山大学、重庆大学、青海大学、西北大学、东北大学等四十余所高校院所的参与学生和老师,共计550余人。本次研讨厅分四个教学班同时进行。第三组汇报的同学是王星宇、周晨旭、李依珊、温江涛;第四组汇报的同学是李明旸、林子清、张少楚、吴子岳;第五组汇报的同学是刘协金、丁竹涵、杨雨、胡昊天;第六组汇报的同学是陈周涵、王一、陈芷谊、易永跃。
教学3班
第一位报告人:王星宇-东北大学
报告题目:Armadillo:具备输入验证的鲁棒单服务器联邦学习安全聚合
点评老师的意见与建议:
1、介绍研究背景时,应该结合实际应用场景举例,让听众更容易理解论文的意义。
2、PPT需要加强整体逻辑,建议增加总体架构图,先讲整体思路,再逐步介绍核心技术。
3、阅读论文时应加强批判性思考,不仅要理解技术原理,还要思考方案的创新和不足。
4、建议尝试将方案应用到无人机协同控制等场景,进一步思考通信效率、容错能力和实际应用的可行性。
第二位报告人:周晨旭-湖南大学
报告题目:Frequency-Domain Signatures for Proactive Defense Against Model Poisoning Attacks in Federated Learning
点评老师的意见与建议:
1、PPT美观度较粗糙。建议统一模板、配色和字体,减少大段文字堆砌,重绘图表并强化层级留白;表格精简、关键数据高亮,避免页面拥挤,提升学术汇报正式感。
2、章节设置建议删去“预备知识”,并入背景或方法;实验部分压缩,只保留主结果、检测性能和鲁棒性;正文篇幅加大,重点讲清主动探测动机、SpecShield流程、频域签名与理论推导。
3、多调研相关其他工作,如联邦投毒防御、频域/小波异常检测、主动探测、模型指纹与后门检测;比较其假设、开销和适用场景,提炼可借鉴点,进一步凸显本文创新与差异。
第三位报告人:李依珊-重庆大学
报告题目:No Honor Among Crooks: Non-transferable Anonymous Tokens from Betrayability
点评老师的意见与建议:
1、需要一个总体的流程图,讲到每一步时回转到流程图,这样逻辑更清晰,思路更明确。
2、思考论文中的不足的地方,在某些极端条件下是否仍然成立,思考出创新的idea。
3、讨论论文对于类似于比特币这种数字资产的应用场景,背景可以拓展。
第四位报告人:温江涛-武汉大学
报告题目:面向AI代理的数据访问权限自动化
点评老师的意见与建议:
1、要讲清楚IC和CF两个模块的设计依据,明确它们分别对应第四章的哪些结论,比如个人在领域内偏好一致对应上下文学习,用户之间偏好相似对应协同过滤。
2、自动授权不等于合理授权,用户本身有过度授权倾向,后续可以结合主观偏好和客观最小数据需求来校准,而不只是学习用户习惯。
3、第5页“可靠执行”要写完整,说明已有研究能够解决;同时建议把第5页做成流程图,按照理解偏好、预测模型、评估验证三部分串联,作为全篇纲目,并在每页总结句上用红色标注。
4、建议把基于角色、基于任务、基于属性的传统访问控制模型和本文工作结合,尽量给出形式化模型,提升普适性和泛化性。
方老师点评:
1、论文中让误允许率和误拒绝率相等并不合理,这等于把安全问题变成纯数学问题。在权限场景下安全更重要,信息一旦泄露就追不回来,所以误允许的代价更高,应该让误允许率更低。
2、训练数据本身可能不可靠,有人觉得信息不重要就随便授权,用这种数据训练模型,学到的偏好未必安全。
3、建议引入《数据安全法》和《个人信息保护法》中的最少必要原则,用客观规则支撑冷启动,比单纯训练用户偏好更有效。4、读论文不能只懂作者怎么做,还要多思辨作者的出发点,想一想自己能不能换一种做法,这样才能真正改进和提升。
教学4班
第一位报告人:李明旸-北京信息科技大学
报告题目:Cloak, Honey, Trap: Proactive Defenses Against LLM Agents
点评老师的意见与建议:
1、进一步探索论文所提出的主动防御框架在不同场景下的稳定性,分析其适用条件与局限,深化对实验结果及防御效果的理解。
2、汇报PPT的结构框架与版面设计仍有改进空间,应进一步梳理内容层次,优化页面布局,使汇报逻辑和重点更加清晰。
3、论文讲解应更多从Agent的角度分析防御的可行性,围绕Agent的信息获取、知识更新、任务规划与行动执行过程,解释防御技术如何产生影响,以及在什么条件下能够生效。
第二位报告人:林子清-北京大学
报告题目:ShadowBinding:构建高效的核内安全推测执行微体系结构
点评老师的意见和建议:
1、尽量不要读讲稿
2、讲解时应先说明 STT / NDA 这样设计的目的
3、对于听众不熟悉的领域要先讲解基本概念,少使用缩写
4、思考文章的改进方案,例如针对其它 Spectre 攻击
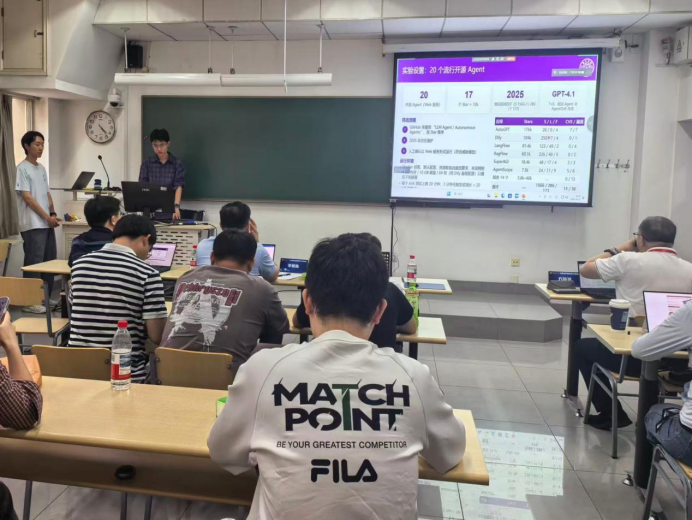
第三位报告人:张少楚-清华大学
报告题目:Autonomy Comes with Costs: Detecting Denial-of-Service Vulnerabilities Caused by Resource Abusing in LLM-based Agents
点评老师的意见与建议:
1、理解论文标题“自主性伴随着代价”,不一定自主性越高代价越高。
2、应讲清楚论文的漏洞检测针对的是智能体而非大模型。
3、产生资源耗尽攻击漏洞的原因主要在开发者资源生命周期管理的失当。
4、对sink等领域专有名词概念要加以解释。
方老师点评:
1、汇报最后的总结,要使用通俗的语言讲解论文脉络。
2、论文通过实际验证服务不可用来判定漏洞,理论上其他的异常漂移情况也应算作漏洞。
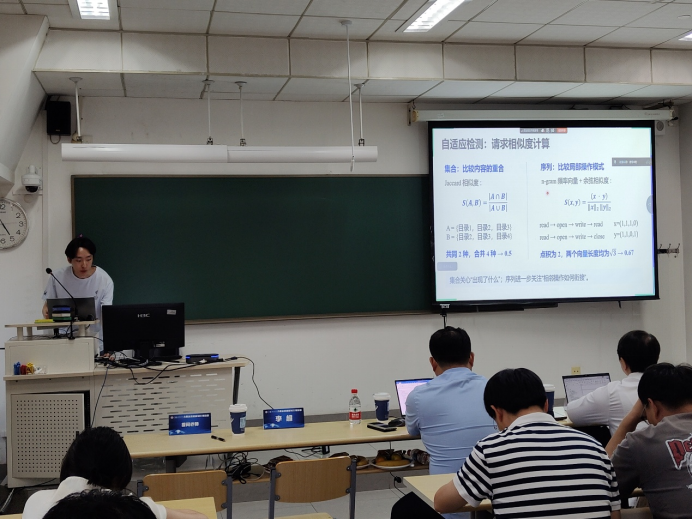
第四位报告人:吴子岳-北京交通大学
报告题目:APIECHO Training-less Anomaly Detection via Intra-API Behavioral Comparison for Web Applications
点评老师的意见与建议:
1、建议在方法论讲解中增加具体实例,直观展示请求特征提取过程及多维特征划分逻辑。
2、建议优化PPT整体结构,将导航页按阶段分层呈现,增强内容层次感和听众理解效率。
3、应明确该方法主要适用于特定应用,由于不同应用的后端调用机制存在差异,方法的跨应用泛化能力有限。
4、应讲清楚方法的核心假设,即攻击行为与正常操作序列存在差异,通过滑动窗口比较请求特征与历史行为,实现异常检测。
5、应进一步分析方法的局限性,包括对已知攻击规则的依赖、日志可信性、滑动窗口长度设置,以及复杂业务场景下的适应性问题。
教学 5 班
第一位报告人:刘协金—广东工业大学
报告题目:Predictive Response Optimization:Using Reinforcement Learning to Fight Online Social Network Abuse
点评老师的意见与建议:
1、要先看懂文章,再讲清楚,重点讲明白"为什么创新、设计为什么巧妙",讲的过程要把背景、方法、实验、结论之间串联起来。
2、实验里的评估指标换了一个角度,不再是传统的准确率、召回率,这一点ppt没有体现出来,以及ppt有对论文内容有缺失。
3、论文里举了很多种abuse,但实验里实际只做了"加权抓取请求"这一个;cost也只用了活跃天数这类指标,没有把"对正常用户的伤害"算进去。论文中目标函数里优化的是全局方案,所有人共用一套处理方式,没有考虑个性化;未来可以往"按用户情况定制方案"这个方向思考。
第二位报告人:丁竹涵-北京大学
报告题目:The Last-Level Branch Predictor Revisited
点评老师的意见与建议:
1、对于某一类特定的工作负载,我们能否提供不同的配置以适应不同的场景?
2、能否尝试通过机器学习等方式,离线学习、标识哪些指令是H2P,那些指令是E2P?
方老师点评:
1、报告的内容需要再进一步提炼、归纳,也可以采用比喻、类比等方式,让演讲更容易被大家接受、理解。2.内容的熵减也能便于我们思考问题,更清晰地把握问题的本质。
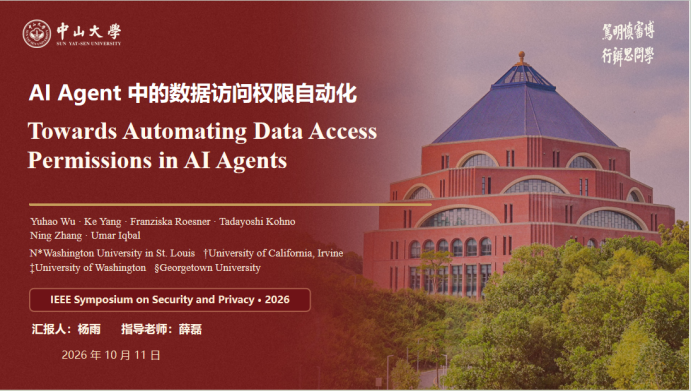
第三位报告人:杨雨-中山大学
报告题目:Towards Automating Data Access Permissions in AI Agents
点评老师的意见与建议:
1、直指自动化授权信任悖论,探讨“Agent与网站谁更值得信任”及全量敏感信息交Agent的伦理边界。
2、需在个性化与隐私安全间平衡,警惕“首创”不等于“有落地价值”。
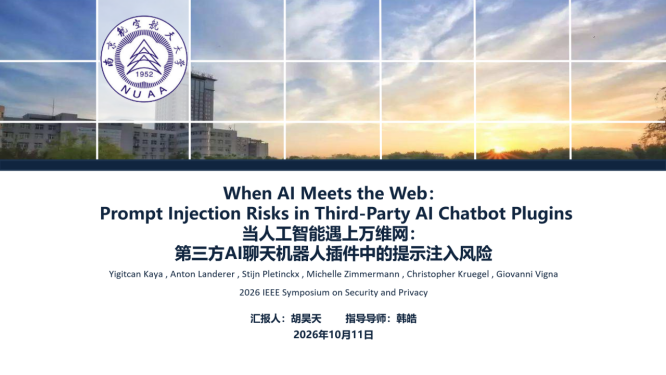
第四位报告人:胡昊天-南京航空航天大学
报告题目:When AI Meets the Web: Prompt Injection Risks in Third‑Party AI Chatbot Plugins
点评老师的意见与建议:
1、把握论文的核心研究问题,理清插件实现、实际配置与实验验证之间的逻辑,合理分配漏洞和防御部分的讲解篇幅。
2、明确风险的承担主体,区分网站、插件与大模型的角色,说明攻击对网站拥有者及其业务的影响。
3、思考角色信息无法被探测时攻击是否仍然成立,明确攻击条件与防御边界,避免结论过于绝对。
教学6班
第一位报告人:陈周涵-北京交通大学
报告题目:ControlLoc: Physical-World Hijacking Attack on Camera-based Perception in Autonomous Driving
点评老师的意见与建议:
1、题目需修改:"劫持攻击"太宽泛,应限定为"跟踪器的劫持攻击";"基于摄像头感知"未体现核心方法(OD+MOT)。
2、问题本质要讲透:单目标检测无法保证连续性,必须多目标检测才能应对物理世界的攻击;真实场景中视角与光线连续变化,用补丁实现连续欺骗极难。
3、抓住论文的底层漏洞:MOT"记性好、忘得慢"(连续多帧才认、连续多帧才算消失),本意是防误检误删,论文正是利用它绕开连续一致性要求——看懂这点才能讲清算法为何分阶段、第三阶段为何分三步走。
4、实验结果要分清感知级与系统级:79% 为感知级(骗过"眼睛"),77.5%/84% 为系统级(骗过决策),真正成功率应是 79%×77.5%;感知级用离线数据、系统级用仿真数据,讲述顺序建议先感知级后系统级。
5、数据前后矛盾需逐一核对:摘要 84.4% 与正文 77.5%(差 6.9%)、摘要 93.6% 与第 5 节 82.9%(差 13.4%)、move out 72.1% 与 72.5% 等。
6、局限性与商业价值要讲清:须已知 OD 架构参数与 MOT 关联参数,商业上拿不到、无法闭环;低速时失效;不支持多传感器融合;未覆盖雨雪雾等全天候;未做高速场景。
方老师意见建议:
1、讲解时要抓住核心问题,并用最简单的话把它说明白,让听众一下就懂:核心就是把本来没有的车变成冒出来/偏过来的车让对方急刹车,把有的车变成“没有”让对方撞上去。
2、要讲自己的理解,而不是复述论文或大模型的语言。大模型说出来的话都对,但不是自己的东西;要能不看 PPT、脱稿把论文讲清楚,把文章放一边在脑子里重建一遍,接不上的断点恰恰就是文章没做、没讲清的地方。
3、技术关键要讲透:为什么不能直接贴一块补丁就把框挪到主路上?因为有多目标跟踪的连续一致性与轨道关联,凭空冒出的“无源之水”会被判为幻觉而废掉,所以必须一点一点挪;而且要用两块补丁相互配合,一块让目标框上移,另一块让原来那辆车“消失”,让它认为是旁边这辆车偏移过来的。
4、文章缺少时序与反馈闭环:什么时候放第一针、第二针,应该由自车的距离和视角来决定,例如大约 10 米处投放才有效,32 寸屏在 20 米太小、1 米又太大,这套反馈体系文章并没有做。
5、建议多读对抗样本方面的文献——这本质上是一个对抗样本的选择问题;同时要往高处讲,抓住最重要的点,不必纠缠过细的细节。
第二位报告人:王一-北京交通大学
报告题目:幽灵导航:重新审视自动驾驶定位模块的隐藏脆弱性
点评老师的意见与建议:
1、攻击方法在现实中难以实现:现实中注入GPS欺骗数据困难,且论文方法只在极低速实车软件注入和仿真平台低速模拟,现实攻击的参考意义有待考虑。
2、论文前后有相矛盾的论述:论文中有出现实验结果互相矛盾的问题,在研读论文阶段还需要更加细致和保持质疑精神。
3、论文研究方法不够简明扼要:在汇报时应当突出论文重点,如主要的攻击方法和实际实施攻击方法。
4、后续建议方向:增加对于论文背景知识和内容的理解,更注重论文本身的实际价值和意义。
第三位报告人:陈芷谊-华南理工大学
报告题目:TEST-TIME POISONED SAMPLE DETECTION BY EX- PLOITING SHALLOW MALICIOUS MATCHING IN BACK- DOORED CLIP
点评老师的意见与建议:
1、论文使用的数据集为公开数据集,实验中良性样本假设较于理想化,与现实场景可能存在差异。
2、针对论文提出的九种变体,可考虑引入随机化策略,以增强检测方法的鲁棒性。
3、汇报中对论文方法的局限性以及现有不足讨论不够充分,应加强对论文缺陷的分析。
4、PPT汇报内容较多,应围绕汇报大纲提炼内容,合理控制汇报时间。
第四位报告人:易永跃-澳门大学
报告题目:通过自信息重写攻击揭示文本水印的弱点
点评老师的意见与建议:
1、肯定选题价值:AI 生成文本泛滥背景下,文本水印是真实且紧迫的问题;建议沿此方向继续深入研究,落实方班“看得懂、说得清、辨得明、用得上”的要求。
2、指出第一个软肋:对非高熵水印(尤其语义不变类的 SIR、EXP)定位会失效,攻击成功率明显下降。
3、指出第二个软肋:攻击模型与文本生成模型不一致时,若条件概率分布不一致,定位同样会失效。
4、建议后续拓展三个方向:解决上述两个软肋;关注论文未涉及的蜜罐水印;在非高熵水印与攻防模型不一致的情形下提升攻击能力。
