第232期方班学术研讨厅成功举办
2026 年9月24日 18:00-21:30,第232期方班学术研讨厅在黄埔研究生院B2栋成功举办。广州大学网络空间安全学院名誉院长方滨兴老师,主点评孔志印老师,张彦春老师,周万雷老师,徐贯东老师,梅宏老师,管晓宏老师,副点评卢璨老师,陈艳利老师,吴昊天老师,唐可可老师,潘梓彬老师,欧阳典老师,张鹏老师全程参与了课堂的教学,并对同学们的报告逐一进行了指导点评。同时参与的还有网络空间安全学院的部分老师,广州大学方班九期的251名学生。本次研讨厅分为七个小组进行。第一组汇报的同学有李怡豪,吴镇炜,谢文健,王洋;第二组汇报的同学有陈正扬,代雨欣,戴泽宇,张兆轩;第三组汇报的同学有成慧佳,方鑫,方俊,杨子衡;第四组汇报的同学有陈凯,陈竞远,林俊,张世展;第五组汇报的同学有陈瑞达,梁英轩,罗子曦,陈少敏;第六组汇报的同学有胡思源,林哲涵,唐健翔,支小乐;第七组汇报的同学有黄梁森,鲁平发,田晨旭,尚峻宇。
第一组
第一位报告人:【李怡豪】
报告题目:【让智能体对抗智能体:基于大语言模型的智能体中污点式漏洞的自动检测】
点评老师的意见与建议:
1、老师们认为汇报整体思路清晰、内容完整,对论文研究背景、方法框架及实验结论把握准确,体现了报告人较为深入的理解。
2、种子生成、变异及评分均依赖同一大模型,可能产生模型偏好和自我强化,限制漏洞覆盖,建议引入异构模型交叉评估并补充对照实验。
3、面向不同研究方向的听众,建议适当补充污点检测常用方法和关键概念的背景说明,并围绕研究问题精选实验结果,突出论文核心结论。
4、讲解核心概念与方法流程时,可结合具体漏洞案例说明种子生成、反馈调度和定向变异的作用及联系,帮助听众形成直观理解。
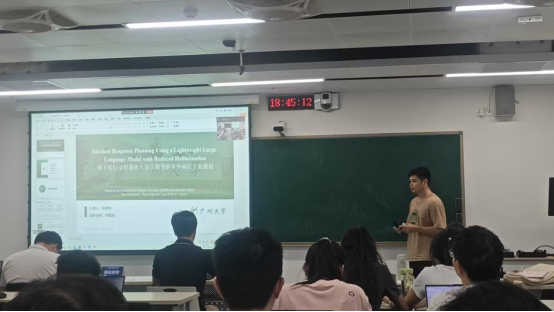
第二位报告人:【吴镇炜】
报告题目:【基于低幻觉轻量化大语言模型的事件响应方案规划】
点评老师的意见与建议:
1、文中说不依赖外部模拟器,但是使用了RAG模块,文中的说法不够严谨。
2、文中的方法是提供决策建议,并不是达到自愈的效果,希望能够明确文中描述的内容。
3、可以自己动手去复现这篇论文的方法。
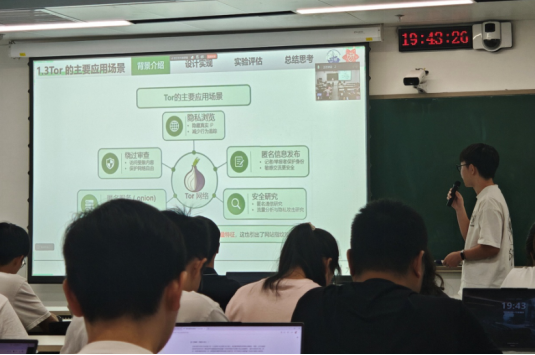
第三位报告人:【谢文健】
报告题目:【COUNTMAMBA:一种基于粗粒度表示与细粒度预测的通用网站指纹攻击】
点评老师的意见与建议:
1、文献研读不够全面,理解深度不足,需进一步加强对研究内容的整体把握。
2、部分专业名词未作解释,核心概念界定不清。
第四位报告人:【王洋】
报告题目:【RAT:基于深度强化学习的智能体定向行为对抗攻击】
点评老师的意见与建议:
1、论文的基本信息可以更加全面一点,比如说论文的发表时间等等。
2、论文整体内容不错,逻辑连贯,但是公式有点多,可以适当的减少或者用通俗的话来解释。
3、本文基于人类偏好训练奖励模型,相较先前方法训练成本是否上升,该设计的优势值得思考。
第二组
第一位报告人:【陈正扬】
报告题目:【YuraScanner:利用大型语言模型(LLM)进行任务驱动型Web应用扫描】
点评老师的意见与建议:
1、应该针对例子讲解时详细说明论文的创新点,相较于传统漏洞扫描器任务如何规划的,使听众了解更清晰。
2、实验部分和自我思考部分讲解较好,但若在实验分析结束之后再次引用案例进行说明会使论文创新点更加清晰。
3、讲解缺乏形式化、总结性的东西。实验时的非自动化部分作者是如何做的?读者如何进行实验复现?应当将这一个流程规范化、作总结。
第二位报告人:【代雨欣】
报告题目:【状态图:使用大型语言模型解决溯因任务】
点评老师的意见与建议:
1、报告需对比演绎与溯因推理差异,阐明溯因推理搜索空间大、难度更高,厘清四类挑战并非溯因独有,解释现有演绎模型迁移效果差的原因。
2、后续可结合知识图谱与 RAG 开展研究,改善状态图更新、标签精度问题,提升溯因推理性能。
论文提出的框架在医学场景匹配度未达临床标准,专家分组划分标准模糊,实际落地还存在较大困难
第三位报告人:【戴泽宇】
报告题目:【WebCloak:量化大语言模型驱动的网络代理作为智能爬虫的威胁并缓解威胁】
点评老师的意见与建议:
1、该项目的具体逻辑还算到位,后续工作应添加如何区分恶意agent和普通用户agent。
2、需要更多更细致的对项目背景进行介绍,同时应该优化实验数据的表现以及文字描述,使得对比实验结果更清晰,文字描述更简练。
3、防御爬虫的方式在动态结构混淆以及优化语义迷宫,既然动态结构混淆成功率已经足够高,为何需要添加语义迷宫?文章的逻辑有一定的漏洞。
第四位报告人:【张兆轩】
报告题目:【基于扩散的对抗身份篡改用于面部隐私保护】
点评老师的意见与建议:
1、PPT的公式比较多,不应该只用数学符号去表示这些数学符号,而是用一些图片,比如前面的目标图和原图的人脸图片,这样可以更好去理解。
2、项目背景分析到位,但是应该要回去看一下之前这篇论文的前作,因为这篇论文不是首次提出这个机制,而是基于上一篇论文做的改进。
3、公式的理解没有到位,主要没有理解每一个模块的本质的作用,同时应该联系到项目的需求去看公式,而不是被公式带偏。
第三组
第一位报告人:【成慧佳】
报告题目:【Unveiling Privacy Risks in LLM Agent Memory】
点评老师的意见与建议:
1、安全护栏、ReAct 观测验证机制可抵御单轮攻击,建议探究提示词伪装、多轮分片注入等攻击拓展思路。
2、实验仅完成消融实验,缺少同数据集下与同类SOTA的横向对比,需补充基线对比增强实验说服力。
3、论文工程实现充足,但创新有限,跨用户混用上下文的强假设与现实会话隔离场景不符,汇报需点明假设及其缺陷。
4、汇报叙事逻辑需要优化,采用攻防双视角讲解;需要进一步补充模块设计动机,厘清论文贡献部分表述。
第二位报告人:【方鑫】
报告题目:【Remote State Estimation Under Strategic DoS Attack Policy: Tackling Joint Constraints】
点评老师的意见与建议:
1、研究建模思路具有创新性,但部分前提假设脱离现实,相关验证工作严谨性有待加强。
2、可进一步探讨全局观测假设的合理性,分析攻击优化方案存在的潜在安全风险。
3、攻防场景建模需贴近实际,破除攻击者全知、防御无响应这类理想化强假设。
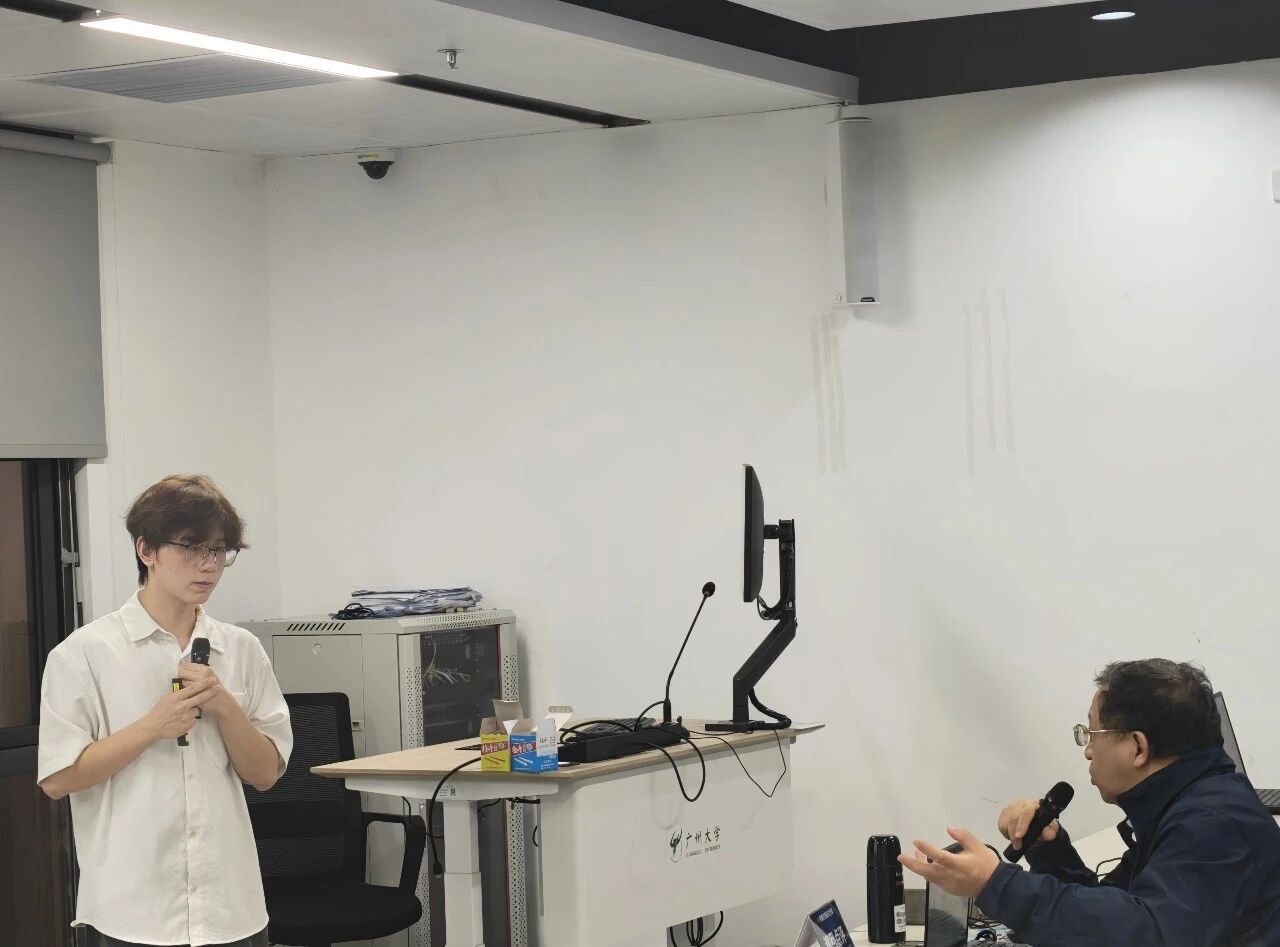
第三位报告人:【方俊】
报告题目:【Multi-agent Architecture Search via Agentic Supernet】
点评老师的意见与建议:
1、实验只采用了四类固定算子,容易使问题与算子固化匹配;建议扩展算子的空间,在智能体的层面来动态搜索。
2、优化目标应该要纳入推理路径的正确性,避免只看答案质量和 Token 消耗,从而导致结果正确但推理过程的错误。
3、控制器可能成为提示注入入口,可能会受到攻击,需要评估其对协作模式选择及模型安全边界的影响。
4、方法讲得跨度有点大,应该先说清超网络是什么、包含哪些候选架构,再讲怎么在上面做架构搜索,讲清其与多智能体框架、架构搜索的关系。
方老师点评:
1、用具体案例讲清研究问题、算子与任务的对应关系,并展示算子选择过程。
2、避免同类问题固定匹配同一算子;说明智能体如何搜索,以及与蒙特卡洛、控制器预测模型的关系。
3、若使用“梯度”描述优化超网中算子的过程,尽量用通俗易懂的话来讲,要让别人听得懂。若只是文字修改意见,应准确说明更新机制。
第四位报告人:【杨子衡】
报告题目:【Privacy-Preserving V2X Collaborative Perception Integrating Unknown Collaborators】
点评老师的意见与建议:
1、背景故事铺垫不足。建议以自动驾驶中的视野遮挡为例,说明协同感知的必要性,再引出跨厂商协作的研究问题。
2、应审慎界定隐私保护效果。协同过程中仍需交换中间特征,建议分析其中可能泄露的信息及现有方法的保护边界。
3、方法依赖预训练和公开数据,应分析车辆模型更新后的适配能力,并补充实验验证公开数据质量对效果的影响。
4、PPT对前人工作、数据集和实验场景的介绍过简,建议补充方法全称、数据来源及场景差异,讲清研究脉络。
第四组
第一位报告人:【陈凯】
报告题目:【Crescendo:一种多轮渐进式大语言模型越狱攻击方法】
点评老师的意见与建议:
1、整体上,讲述还算清晰,PPT制作也可以,但文章贡献并没进行突出讲解。
2、论文发布有些早,现在已经对这类方法进行了改进,可以进行进一步的研究
3、从讲述来说,上下文的利用是很重要的,但在进行方法和流程介绍的时候,讲的内容有些重复,没有表现出来上下文的利用。
4、背景介绍部分,介绍的逻辑顺序有些问题,应当由越狱攻击引出安全对齐。
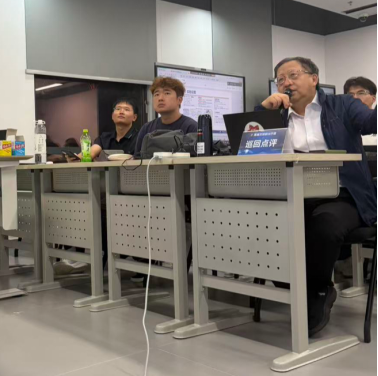
第二位报告人:【陈竞远】
报告题目:【BADROBOT : 具身大语言模型越狱攻击——面向物理世界机器人智能体】
点评老师的意见与建议:
1、老师确认攻击机制:是否先将语音转为JSON、再转为动作序列输入机器,攻击是否仅限前端语义转换、与机械臂物理运行无关。
2、老师询问后续研究计划,并追问该方法是否等同于将普通大模型的越狱手段迁移到具身智能场景重新验证。
3、老师质疑实验设置:2块A100与256G内存是否仅用于运行虚幻引擎,虚拟世界测试是否可信,为何不在现实中验证。
4、老师就AI安全与伦理发问:不可越狱究竟是好事还是坏事,对外部机构无法攻破的模型该如何监管,是否已上升为道德哲学问题。
方老师点评:
1、方老师提出“不安全”的层级划分问题:究竟指模型层、智能体层还是整个系统,仅用响应概率衡量是否足够精准。
2、方老师指出传统越狱只关注语言输出,具身场景还须考虑动作的物理可达性与环境约束,模型响应恶意指令后能否真正执行。
3、方老师质疑“言行不一致导致不安全”的逻辑:若智能体被攻击后高度一致地执行恶意指令,是否反而更危险,安全判据是否应修正。
4、方老师提醒强化学习下的目标冲突:安全监控与主任务共存是否会因多目标干扰失效,自主追求是否会衍生破坏性子目标。
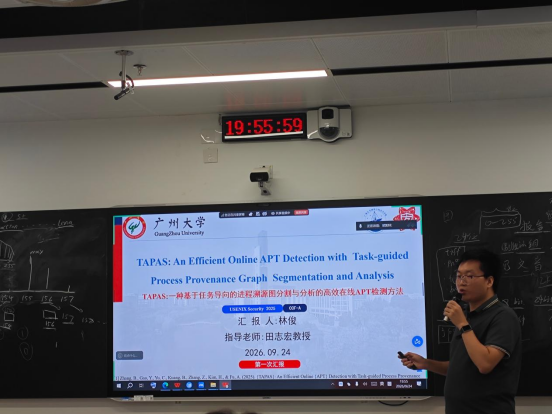
第三位报告人:【林俊】
报告题目:【TAPAS:一种基于任务导向的进程溯源图分割与分析的高效在线APT检测方法】
点评老师的意见与建议:
1、讲述流畅,逻辑通顺,之后可以在相关工作那边列出与文章所挑战问题相关的文献可以更好的与后面衔接
2、总结与反思部分关于子图复现的部分想法很好,但动态分割子图这个思路不太现实,会导致大量的时间开销。复现的部分很好,研一做到这样很不错
3、之后的溯源图工作不应该是单纯的通过提前训练可以二分类的模型又或者是只用良性子图进行训练,而是要多个模块相互结合
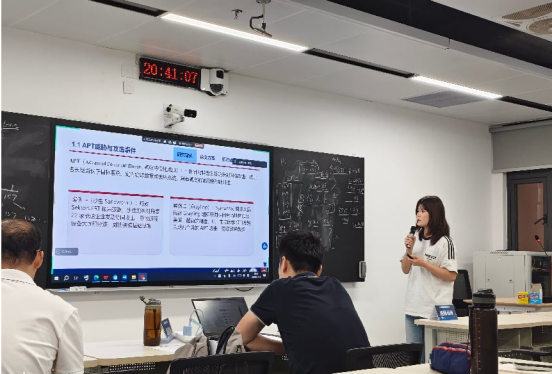
第四位报告人:【张世展】
报告题目:【Slot:基于图强化学习与溯源驱动的APT检测】
点评老师的意见与建议:
1、论文方法流程讲解缺乏连贯性,各步骤之间关联没有讲清,听众难以抓住核心逻辑,需要梳理完整研究流程,明确每个环节作用。
2、对核心问题理解不深入,未解释攻击者添加良性邻居会使普通 GNN 洗白恶意行为的内在原因,动机部分论述不足。
3、论文核心创新点共两处,汇报应围绕这两点分层展开,不要罗列过多小节,突出核心贡献。
第五组
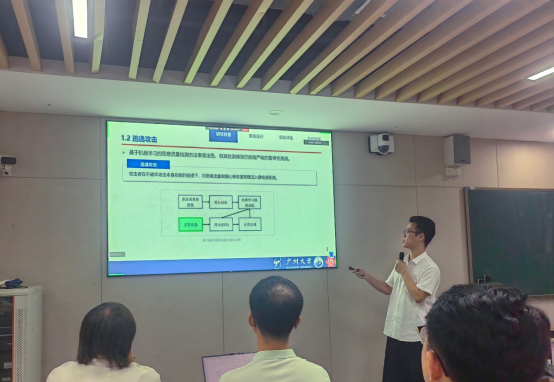
第一位报告人:【陈瑞达】
报告题目:【针对机器学习恶意流量检测系统的硬标签黑盒逃逸攻击】
点评老师的意见与建议:
1、应该进一步强调强化学习和在黑盒场景下做优化的关系,同时考虑增加对数据包调序这一的动作所带来的动作空间爆炸的问题。(李默涵老师)
2、应该对实验图表中的各项指标进行进一步的解释。(潘梓彬老师)
方老师点评:
1、思考用强化学习网络来进行良性流量学习的可能性。
2、思考该逃逸攻击方法的能力边界,同时考虑现有的目标检测系统检测诱饵包的方法。
第二位报告人:【梁英轩】
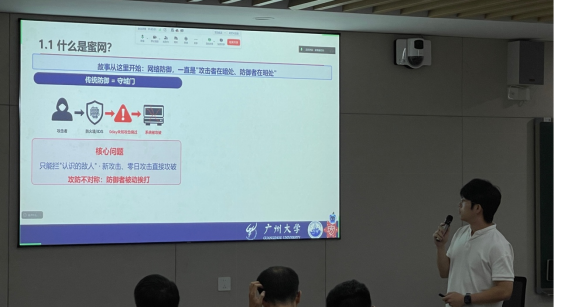
报告题目:【基于博弈论的拟态蜜网安全部署方法】
点评老师的意见与建议:
1、核心创新应聚焦动态异构冗余执行体的两层裁决机制及其效果,博弈论为现成方法,不应作为主要贡献展开。
2、多层异构蜜罐与纳什博弈缺乏内在逻辑关联,呈A+B式组合,需厘清二者如何协同解决蜜罐自身安全问题。
3、威胁模型与适用假设未明确;实验环境理想化、参数静态设置,真实动态网络中效果可能衰减,需补充验证。
第三位报告人:【陈少敏】
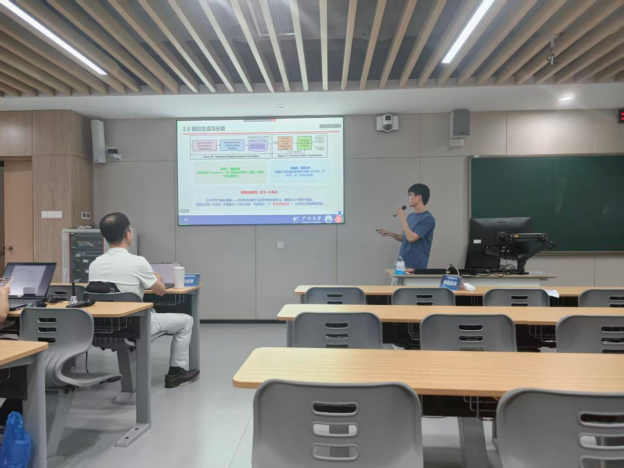
报告题目:【EO-EPTC:基于端到端原始流量的加密代理流量分类框架】
点评老师的意见与建议:
1、该框架依赖原始流量与代理流量一对一映射的强假设,未评估假设不成立时性能下降幅度,假设偏理想化。
2、实验中不同分类器提升效果差异明显(84%至97%),与分类器无关的结论存在矛盾,有待进一步验证。
3、方法模块讲解偏简略,Transformer选型理由、自注意力机制处理四类差异的方式、损失函数及优化目标等关键内容缺少解释。
4、框架通过流量翻译获得更强表征向量提升分类效果,但四类对齐模式通用性存疑,论文引用量偏低,需批判审视创新价值与适用范围。
第四位报告人:【罗子曦】
报告题目:【KnowHow:自动应用高级CTI知识进行可解释和准确的溯源分析】
点评老师的意见与建议:
1、报告的整体组织和讲述较流畅,对论文局限性的思考也较到位。但方法模块讲得较多,为什么选用 SVO、FastText 和字段相似度检测等方法,解释还不够清楚。建议在介绍挑战和对应模块后,明确各模块的创新点与设计依据。
2、异常阈值自动确定的过程讲解不足。建议补充正常事件如何参与阈值确定,以及 Grubbs 检验在其中如何使用,不能只略述最终结果。
3、建议了解论文代码是否公开、能否复现,并进一步分析方法的计算开销。针对可能存在的开销问题,可考虑采用更轻量的技术,在保持检测效果的同时降低成本。
4、方法效果受 CTI 报告的完整性、覆盖范围和质量影响。建议进一步思考如何扩充知识来源、提高知识抽取质量,并引入自然语言处理方法改进语义匹配。
第六组
第一位报告人:【胡思源】
报告题目:【先学移动,再学做事:面向视觉-语言-动作模型的任务无关预训练】
点评老师的意见与建议:
1、讲解逻辑清晰,PPT简洁明了
2、在实验部分中,论文方法与传统方法的指标对比讲解得不够充分
3、要明确论文中“物理先验”和“运动能力”在概念上的区别
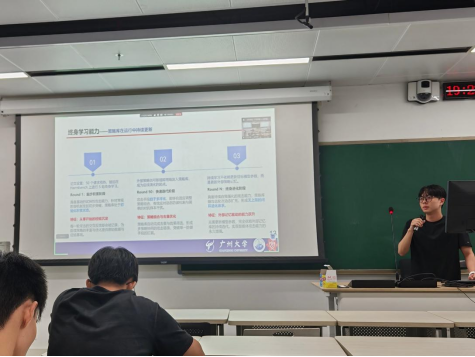
第二位报告人:【林哲涵】
报告题目:【AutoDAN-Turbo:一种面向大语言模型越狱攻击的策略自主探索终身智能体】
点评老师的意见与建议:
1、选题有想法,但只在提示词层绕对齐,不碰底层安全机制;检索粗、易刷分、无淘汰降权,ASR只衡量越狱程度,属“笨办法广试”。
2、本文是前作AutoDAN的“涡轮增压版”,加library+检索才成闭环;但没读前作、没跟新工作,skill/library思路已不新,建议补引用。
3、缺少复现、没查作者背景、没跟256个引用正反文献。
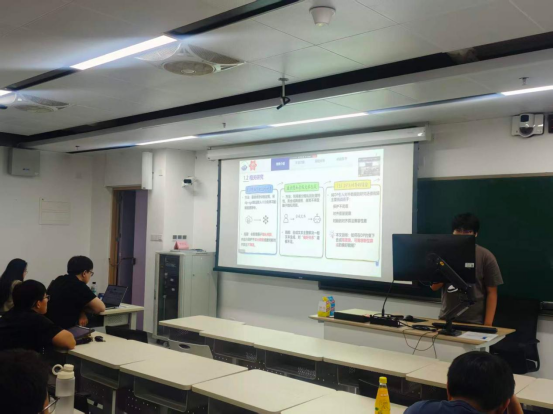
第三位报告人:【唐健翔】
报告题目:【面向大语言模型对齐的差异性私有偏好数据合成】
点评老师的意见与建议:
1、没有讲清楚相关研究,第二章部分直接讲步骤没有想法动机,没有讲清楚定义动作。
2、文章到底是生成是合成数据讲的不清楚,若是合成数据,须说明数据来源、规模、生成方式、用途及是否有真实数据对照验证,还是生成数据,比如数据集,同时不能只读一篇,要把相关文献通读一遍,交代本文与已有工作的关系和差异。
第四位报告人:【支小乐】
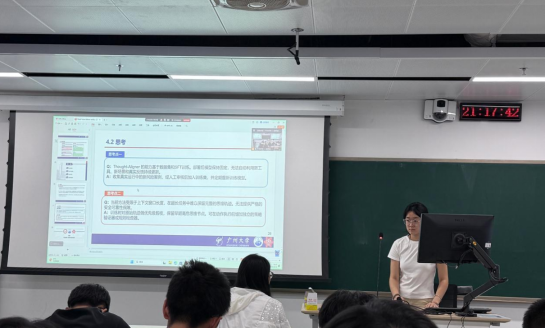
报告题目:【Think Twice Before You Act: Enhancing Agent Behavioral Safety with Thought Correction】
点评老师的意见与建议:
1、提出新方案前,应梳理既有方案及其局限。
2、需区分推断与推理:前者给出结果,后者强调过程。
3、思维链是问题求解和推理的基础;从其入手处理智能体安全确实具有创新性,但需验证方案可迁移性。
4、阅读论文应关注同类研究,通过横向比较深化理解。
第七组
第一位报告人:【黄梁森】
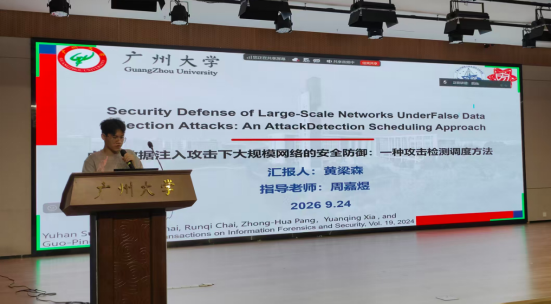
报告题目:【虚假数据注入攻击下大规模网络的安全防御:一种攻击检测调度方法】
点评老师的意见与建议:
1、研究背景与实际问题结合不够紧密,对“虚假数据注入攻击下的检测调度”问题的现实需求阐释不足。
2、相关工作介绍较为笼统,应进一步梳理已有检测方法及代表性方案,明确现有研究的不足。
3、研究空白与技术挑战阐述不够深入,应进一步说明检测节点选择的具体难点及方法面临的约束。
4、方法流程较为清晰,但需进一步说明各步骤的输入、建模方式、优化目标、约束条件及输出。
第二位报告人:【鲁平发】
报告题目:【高级工业蜜罐:用于逼真ICS协议仿真的有限状态机和大语言模型集成】
点评老师的意见与建议:
1、老师针对RAG、有限状态机的结合原理提出多个技术问题,指出我对RAG技术理解不够透彻。建议线下进一步吃透RAG的原理与当前行业发展现状。
2、论文选题本身有研究意义,但所选IEEE TII为CCF C类期刊,后续研读文献建议优先选择CCF A类顶刊。
3、论文存在几处局限:未考虑攻防双方AI对抗(AI识别蜜罐)的场景;实验仅验证西门子设备,跨厂商泛化性、通信时延等工程问题讨论不足。
第三位报告人:【田晨旭】
报告题目:【诱骗AI:针对AI保护下工业基础设施的对抗攻击】
点评老师的意见与建议:
1、本文的选题是很有意义的,对于工业系统安全方面,AI作为攻击方的效果是远好于防御者的;利用AI作为攻击方,可以接受多次的失败,但作为防守方,工业系统可能难以承受过高的误报率。
2、论文里的方向,也就是利用AI自动化进行攻击,是需要注重的方向;本文使用的强化学习多智能体,随着人工智能的发展,不一定要采用文中马尔科夫模型或者传统建模方式,可能会有更好的攻击建模。
3、关于论文里的时序攻击,它是如何被AI检测出来的,会不会有误报的情况发生,本文进行时序攻击的限制前提有很多,对于更一般的工业场景是否能有效,仍需进一步的验证。
4、关于论文里的强化学习,里面的策略主要是依靠奖励进行优化,在现实的攻击场景中,往往很多的数据是难以获取的,也就很难进行反馈。需要根据这种情况对系统进行改造。
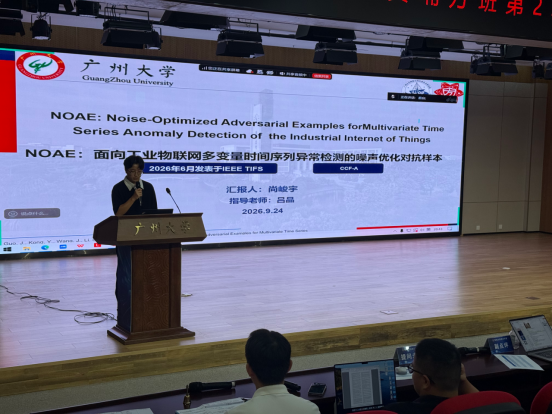
第四位报告人:【尚峻宇】
报告题目:【NOAE:面向工业物联网多变量时间序列异常检测的噪声优化对抗样本】
点评老师的意见与建议:
1、攻击影响评价指标不够清晰;隐秘性与攻击强度存在权衡矛盾,固定损失权重可改为面向实际场景的优化问题。
2、论文核心是目标函数,需围绕“添加噪声、躲避检测且不使数据过度异常”展开,可进一步拓展对抗相关研究。
3、面向异常检测的对抗研究具备应用价值,但该方法适配工业实际场景难度较大,落地存在挑战。